所屬科目:專技◆公共衛生師◆生物統計學
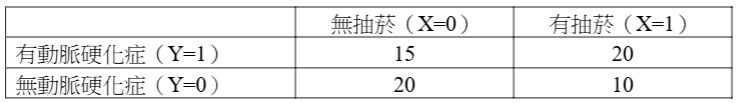
1.想了解抽菸和動脈硬化症間的相關性,利用世代研究得到下面列聯表:
請問有抽菸者有動脈硬化症的機率相對於無抽菸者有動脈硬化症的機率約為多少?(選出最接近的選項) (A) 2.67 (B) 0.38 (C) 1.56 (D) 0.65
2.利用 X 光來篩檢結核病,敏感度為 84.8%、特異度為 95.6%,若結核病的盛行率為 0.0001, 隨機抽取一個人進行檢查,其胸部 X 光的檢查為陽性,其真正有病的機率約為多少? (A) 0.152 (B) 0.0019 (C) 0.044 (D)<0.0001
3.下表為沙克疫苗的大型試驗結果,注射沙克疫苗或是安慰劑之後得到小兒麻痺的人數,由試 驗結果得到注射沙克疫苗相對安慰劑得到小兒麻痺的勝算比(odds ratio)為何?(A) 0.000164 (B) 0.000572 (C) 0.2875 (D) 0.3301
4.臺灣母親懷孕滿 38 週之新生兒體重分布為常態分布,平均值為μ(單位:g) ,標準差為σ(單 位:g) 。若μ = 2800、σ = 400,從母體隨機抽取樣本數(n)為 25 的一組樣本,則其樣本平 均數會大於 3300 g 的機率約為多少?
\( (Z_{0.005} = 2.58, Z_{0.023} = 2, Z_{0.025} = 1.96, Z_{0.05} = 1.645, Z_{0.1} = 1.28, Z_{0.159} = 1) \) (A) 0.300 (B) 0.100 (C) 0.050 (D)< 0.005
5.若母體標準差已知,樣本數夠大的情形下,估計單一母體平均數的 95%信賴區間,對於此區 間的描述,下列敘述何者錯誤? (A)重複抽取 100 組樣本後,可建構 100 個信賴區間,大約有 95%的區間會包含母體平均數 (B)母體平均數的 95%信賴區間寬度約為 4 個標準誤(Standard error) (C) 95%信賴區間表示此信賴區間包含 95%的樣本觀測值 (D)母體平均數的信賴區間估計必定包含樣本平均數
6.全國健康調查 50 歲到 74 歲去年為健康且無失智的族群,今年將使用簡易心智量表(MMSE, 滿分為 30 分)進行失智檢測,已知平均值μ=27 分,標準差為σ=4 分。在進行樣本數估算時, 要多少樣本數,其母體平均數的 95%信賴區間寬度為 2?(選出最接近的) (A)約 62 人 (B)約 31 人 (C)約 16 人 (D)約 101 人
7.北區衛生局進行地區性的收縮壓調查,共收集 100 個人的收縮壓數值,根據這個樣本計算出收縮壓母體平均數的 95%信賴區間為(109, 130)mmHg。若在調查前已由往年資料得知,收縮壓母體分配為常態分配且母體標準差已知,則下列推測何者錯誤? (A)此調查得到的樣本收縮壓平均數為 119.5 mmHg (B)樣本收縮壓平均數抽樣分配的標準誤約為 5.36 mmHg (C)收縮壓母體標準差約為 43 mmHg (D)依中央極限定理,收縮壓平均數的抽樣分配會服從常態分配
8.一位研究生進行一項關於大學生吸菸習慣的研究。他先從所有大學中隨機抽取 10 所大學,然後再從這 10 所大學中隨機選取了 500 位大學生進行研究,這個研究的母群體為何? (A)本研究來自 10 所大學的 500 位學生 (B)所有大學的大學生 (C)本研究所選取 10 所大學的所有大學生 (D)所有吸菸者
9.在生產流感快篩試劑的品管部門,若要檢定不良率(p)是否不足 0.01,其虛無假設及對立假設為何? (A) H0:p = 0.01 vs HA:p ≠ 0.01 (B) H0:p ≠ 0.01 vs HA:p = 0.01 (C) H0:p ≤ 0.01 vs HA:p > 0.01 (D) H0:p ≥ 0.01 vs HA:p < 0.01
10.臺北兩家教學醫院共收集 300 位不足月出生的嬰兒樣本資料,假設男、女嬰的血氧濃度為常態分配,欲檢定這些不足月出生的嬰兒男孩的平均血氧濃度是否低於女孩的平均血氧濃度, 其虛無假設及對立假設為何?(μ 為女嬰之血氧濃度平均數、μ 為男嬰之血氧濃度平均數) (A)\(H_0: \mu_1 - \mu_0 < 0\) vs \(H_A: \mu_1 - \mu_0 \ge 0\) (B)\(H_0 : \mu_1 - \mu_0 \le 0\) vs \(H_A : \mu_1 - \mu_0 > 0\) (C)\(H_0: \mu_1 - \mu_0 = 0\) vs \(H_A: \mu_1 - \mu_0 \neq 0\) (D)\(H_0: \mu_1 - \mu_0 \ge 0\) vs \(H_A: \mu_1 - \mu_0 < 0\)
11.估計臺灣這三個地區 65 歲以上健康者空腹血糖值的母體變異數約為多少?(依上述表格數值進行計算) (A) 6.239 (B) 9.358 (C) 0.292 (D) 37.596
12.承上題,假設α=0.05,同時假設μ北、μ中、μ南分別代表三地 65 歲以上健康者的空腹血糖值母群體平均數,試比較三地空腹血糖值平均值是否有差異。在設立虛無假設及對立假設,下列何者正確? (A) H0:μ北 = μ中 = μ南 vs HA:H0 至少有一個等號不成立 (B) H0:μ北 = μ中 = μ南 vs HA:μ北 ≠ μ中 ≠ μ南 (C) H0:μ北 = μ中 = μ南 = 0 vs HA:μ北 ≠ μ中 ≠ μ南 ≠ 0 (D) H0:μ北 ≠ μ中 ≠ μ南 vs HA:μ北 = μ中 = μ南
13.想比較男生及女生的血清膽固醇在過去半年內的變化,某研究進行兩組之血清膽固醇的改變 量是否有差異的比較,抽出樣本數各約 300 人,應使用下列那個統計方法進行比較? (A) One-way ANOVA (B)威爾考克森符號等級檢定(Wilcoxon signed rank test) (C)獨立雙樣本平均數檢定 (D)成對樣本平均數檢定
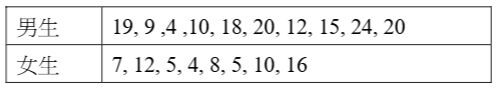
14.某研究收集 8 位女生與 10 位男生樣本,每月的運動天數如下,若要比較男、女的運動天數是否相同,要使用何種統計方法最合適?
(A)獨立雙樣本平均數檢定 (B)威爾考克森等級和檢定(Wilcoxon rank sum test) (C)威爾考克森符號等級檢定(Wilcoxon signed rank test) (D)成對樣本平均數檢定
15.有一研究欲觀察第二型糖尿病患者的風險因子,想了解這個群組中,肥胖對腎臟病變的效應, 將 BMI 分為三組:BMI 過低、BMI 正常、BMI 過高,並比較這三組母群體的平均腎絲球過 濾率(eGFR)的差異,使用 ANOVA 進行分析,利用 Bonferroni 多重比較來進行事後檢定, 並進行檢定顯著水準的調整,調整後的顯著水準約為多少?(整體顯著水準為 0.05) (A) 0.05 (B) 0.0167 (C) 0.0125 (D) 0.0083
16.想了解大學中的性別如何分布,抽樣調查某大學的學生 250 名,其中 112 名為男生,138 名 為女生。利用此調查資料檢定男女比例是否為 1:1,下列那種檢定最為適合? (A)單一樣本比例檢定 (B)獨立雙樣本平均數檢定 (C)獨立雙樣本比例檢定 (D)威爾考克森等級和檢定(Wilcoxon rank sum test)
17.生技公司為確保檢驗結果的正確性,將 6 名受試者血液檢體同時送交甲檢驗室與乙檢驗室,以 了解甲檢驗室與乙檢驗室的紅血球數量的檢驗結果是否有差異。應使用何種方法檢定? (A)威爾考克森符號等級檢定(Wilcoxon signed rank test) (B)威爾考克森等級和檢定(Wilcoxon rank sum test) (C)獨立雙樣本平均數檢定 (D) One-way ANOVA
18.檢定兩個母群體變異數是否相等應採用下列那一個檢定? (A)卡方(Chi-square)檢定 (B) F 檢定 (C) t 檢定 (D) Z 檢定
19.下列對於 Receiver Operating Characteristic Curve(ROC 曲線)的敘述何者錯誤? (A) ROC 曲線的線下面積可作為預測模式的效度指標 (B)一般線性模式可用以建構 ROC 曲線 (C)比較兩個預測模式的 ROC 曲線線下面積可以反應兩個預測模式的預測能力 (D)若 ROC 曲線的座標原點為 0,則 X 軸與 Y 軸分別是 1 - specificity 與 sensitivity
20.檢定某樣本是否來自平均值為 μ0 的母族群,若在該樣本確非來自 μ0 的母族群前提下,且檢 定結果為拒絕 H0 的機率是指下列那一個機率? (A)第一型錯誤(Type I error) (B)第二型錯誤(Type II error) (C)檢定力(power) (D)顯著水準(significant level)
21.若單因子變異數分析(One-way ANOVA)的虛無假設(null hypothesis)為真時,檢定 F 值會: (A)接近 1 (B)接近 0 (C)大於 3.84 (D)接近 MSE 的值
22.若滿足大樣本的假設下,何者情況較不適合使用成對樣本平均數的檢定方法? (A)死亡組的高血壓病人與存活組的高血壓病人,比較兩組的舒張壓是否有所差異 (B)比較班上期中考與期末考成績是否有差異,以學生自己的期末考與期中考成績作為比較基礎 (C)生活在相同環境且同為高血脂的夫妻,比較醫療支出是否有所差異 (D)高血糖病人治療前與治療後血糖值是否有改變
23.某研究想得知麥片( x1= 1)及碳水化合物( x1= 0)攝取,對於血中總膽固醇(Y)的影響, 並調整性別( x2= 1,男生; x2= 0,女生)變項,並考慮交互作用項,得到以下多元線性迴歸模型:
\( \hat{\mu}_y = \hat{\alpha} - 13.25 \times x_1 - 5.21 \times x_2 + 3.38 \times x_1 \times x_2 \),
根據此模型,若考量性別為男生時,食用麥片與食用碳水化合物(參考組) ,兩者血中總膽固 醇平均差值為何? (A)-9.87 (B) 3.38 (C)-8.59 (D)-18.46
24.想了解某醫學大學學生的睡眠狀況與學習表現的相關性,睡眠狀況評估是使用匹茲堡睡眠品 質量表(PSQI,滿分 21 分)、學習表現是以學期等第成績(A+, A, A-…C+, C, C-)評估。 要使用那個統計方法較為合適? (A) Intra-class correlation coefficient (B) Pearson’s correlation coefficient (C) Spearman’s correlation coefficient (D) Cohen’s kappa statistic
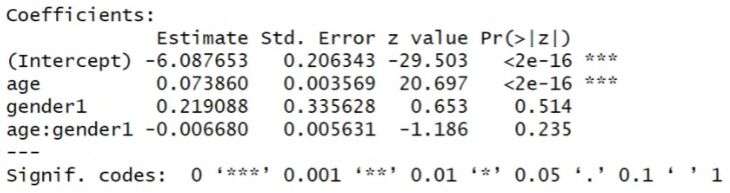
25.若想了解性別與年齡對於中風的影響,是否為中風為 Y(Y=1 為中風;Y=0 為無中風) ,其自 變數年齡(age)(x1,單位:歲)、性別(gender1)( x1=1 為男性; x2=0 為女性),並考慮其 交互作用項 age:gender1,利用 R 分析的結果如下,請判斷是否需要加入交互作用項?(顯著 水準為 0.05)
(A)因交互作用項的 p 值大於 0.05,故此模型不需考慮加入交互作用項 (B)因交互作用項的 p 值大於 0.05,故此模型需考慮加入交互作用項 (C)因交互作用項係數估計為-0.00668,小於 0,故此模型需考慮加入交互作用項 (D)因交互作用項係數估計為-0.00668,很接近 0,故此模型不需考慮加入交互作用項
26.一個簡單線性迴歸模式分析 30 名民眾的身高(x)與體重(y)的相關性,這些樣本民眾的 身高介於 150 至 185 公分之間,體重則是介於 40 至 110 公斤之間,迴歸方程式如下: \( \hat{\mu}_y \)= −120 + 1.14 ,下列那一個敘述正確? (A)該迴歸線不排除身高與體重之間存在非線性關係 (B)可以用此迴歸方程式來預測一名 190 公分民眾的體重 (C)利用此迴歸線來預測一名 170 公分民眾體重所得到的預測誤差會比預測 10 名 170 公分民 眾平均體重所得到的預測誤差大 (D)該迴歸線顯示民眾的身高與體重間存在顯著的正相關性
27.線性迴歸模型和羅吉斯迴歸模型之異同點的描述,下列何者錯誤?(X 代表自變項,Y 代表 依變項) (A)線性迴歸模型和羅吉斯迴歸模型都可處理多個自變項 X 的分析,稱為複迴歸模型 (B)線性迴歸模型只能推得 X 與 Y 的相關性,而羅吉斯迴歸模型則可斷定 X 與 Y 的因果相關性 (C)線性迴歸模型的 Y 為連續變項(常態分配) ,羅吉斯迴歸的 Y 可以為二元變項(二項式分配) (D)線性迴歸模型和羅吉斯迴歸模型的 X 的變數型態皆不受限定,可以是連續型變項、間斷型 變項、類別變項或序位變項
28.若想了解性別與年齡對於中風的影響,建立以下模型,中風與否為 Y(Y=1 為中風;Y=0 為 無中風),其年齡( x1,單位:歲)、性別( x2=1 為男性;x2 =0 為女性)的係數如下:
\( \text{logit}(\widehat{P}(Y=1|x_1,x_2)) = 1.10 + 0.02 \times x_1 + 1.21 \times x_2 \)
一名年齡為 40 歲且為男性,與一名年齡為 30 歲且為女性相比,兩人發生中風的勝算比(odds ratio)約為多少? (A) 1.020 (B) 1.410 (C) 4.096 (D) 3.353
29.一組成對資料,包含肱骨長度( x,單位:公分)和性別(y) ,其中 0 代表女性,1 代表男性, 以此計算出以下羅吉斯方程式(logistic equation):
\( \ln\left(\frac{p}{1-p}\right) \) = −5.1 + 0.236x
若某人肱骨長度為 31 公分,則其為男性的機率最接近下列何值? (A) 2.216 (B) 0.902 (C) 0.098 (D) 0.796
30.下列有關線性相關係數的敘述,那些是正確的?
I:若兩變數之線性相關係數為零,則這兩個變數之間沒有關係。
II:若迴歸線的斜率為負,則線性相關係數為負。
III:線性相關係數的值介於-1 到 1 之間。
IV:線性相關係數為 0.62 的線性關係比線性相關係數為-0.82 的線性關係更強。 (A) I and IV (B) III and IV (C) II and III (D) I and II
31.以一組成對資料建立迴歸模型,得到總變異量(total variation)為 20.711,解釋變異量(explained variation)為 18.592,未解釋變異量(unexplained variation)為 2.119,則此模型的判定係數 (coefficient of determination)為: (A) 1.114 (B) 0.102 (C) 0.898 (D) 0.114
32.迴歸方程式 ŷ=1150+58.3x,迴歸係數檢定的 p 值為 0.017,R²=0.792。下列何者正確? (A)當 x 變化一個單位時,y 的邊際變化為 0.792 (B)迴歸線解釋 y 的變異量為 0.017 (C)當 y 增加一個單位時,x 的邊際變化為 58.3 (D)由於 p 值< 0.05,迴歸係數與 0 有顯著差異
33.若想了解自變數(X)與依變數(Y)的相關性,進行簡單線性迴歸模型及皮爾森(Pearson’s) 相關係數的估計,其模型的截距項及自變數之迴歸係數分別為 β0 及 β1,根據估計結果,下列 敘述何者錯誤? (A)簡單線性迴歸的判定係數剛好是皮爾森相關係數的平方 (B)估計得到皮爾森相關係數的方向,將與 β1 的方向一致 (C)可使用最大概似估計法或最小平方估計簡單線性迴歸係數 (D)若估計後的 β1 大於 0 時,可推得 X 與 Y 具有正相關性
34.想了解中風(Y=0,1)與抽菸量(X=0,1,2)的相關性,利用羅吉斯迴歸進行分析,抽菸量為 0 代表無抽菸者(參考組) ,抽菸量為 1 代表每天平均一包,抽菸量為 2 代表每天平均為兩包或 兩包以上,依變項為中風,Y=1 代表中風、Y=0 代表沒有中風。利用 R 分析得到以下結果 (smoking_level 1 與 smoking_level 2 為兩個虛擬變項分別代表抽菸量 1 與抽菸量 2) 。抽菸量 為 2 與抽菸量為 1 相比,發生中風的勝算比(odds ratio)約為多少?
(A) 1.429 (B) 1.132 (C) 1.263 (D) 0.700
35.我們知道在進行抽樣時,隨機抽樣可以避免偏差發生,也比較能夠得到具有代表母群體特性 的樣本,下列那一種隨機抽樣方法所獲得的樣本較常有資料非獨立(non-independence)的問 題? (A)群集隨機抽樣(Cluster random sampling) (B)分層隨機抽樣(Stratified random sampling) (C)簡單隨機抽樣(Simple random sampling) (D)系統隨機抽樣(Systematic random sampling)
36.下列 Kaplan-Meier 圖(KM plot)為存活分析結果,資料來自肺癌病患資料,事件為死亡發 生,追蹤記錄治療後多久發生死亡的時間,橫軸為存活時間(單位:月),縱軸為存活機率 (survival probability),實線為女性、虛線為男性,並顯示利用對數等級檢定(log-rank test) 的 p 值,如圖所示。請依下圖結果,選出正確選項:
(A)圖中顯示在顯著水準=0.05 下,我們有充分證據證明男、女兩組平均存活天數具顯著差異 (B)圖中出現垂直向下的階梯(steps),代表該時間點有病患失聯或退出研究(設限資料) (C)圖中顯示所有的病患皆觀察到死亡事件發生 (D)此圖男性存活中位數大約為 59 個月,女性的存活中位數大約為 82 個月
37.研究人員利用統計軟體分析了四種肺癌細胞類型患者的存活資料,並在輸出報告中得到分層相等性檢定(Test of Equality over Strata)的結果,其中 Log-Rank 與 Wilcoxon 檢定的 p-value 均小於 0.0001。下列關於此統計結果的解讀,何者最適當? (A)檢定結果表明,這四種癌細胞患者的存活曲線之間存在顯著的差異 (B)檢定結果顯示四種癌細胞患者的存活曲線高度同質,沒有達到統計學上的顯著差異 (C) Log-Rank 與 Wilcoxon 檢定結果互相矛盾,因此無法做出任何有效結論 (D)此結果僅能證明各組中位數存活時間相同,但存活曲線的形狀不同
38.生產一種實驗性疫苗時,為了評估產品容量的變異性,在產線上每 200 支疫苗進行隨機抽樣, 這種抽樣方案能得到隨機樣本嗎?以及是否為簡單隨機樣本? (A)兩者皆是 (B)是隨機樣本,但非簡單隨機樣本 (C)非隨機樣本,但為簡單隨機樣本 (D)兩者皆非
39.一個樣本有 50 個數值,已知該樣本來自一個偏態分布的母群體,母群體標準差未知。要建立 此狀況下母群體分布平均值 µ 的信賴區間,需要使用何種統計量分布? (A)學生 t 分布 (B)常態分布 (C)卡方分布 (D)不適用任何分布
40.成對樣本(paired-sample)t 檢定的檢定結果會與下列那一種檢定方法的結果一致? (A)卡方分布的 McNemar 檢定 (B)成對樣本差異值的單一樣本 t 檢定 (C)小樣本的單一樣本平均值 Z 檢定 (D)無母數的 Wilcoxon signed rank test
一、某研究探討「吸菸」與「高血壓」對發生心血管疾病的影響,建立以 下羅吉斯迴歸模式:
\( \log\left(\frac{p}{1-p}\right) = \beta_0 + \beta_1 X + \beta_2 Z + \beta_3 XZ \)
其中p為發生心血管疾病的機率, X= 1代表有吸菸、 X= 0代表未吸 菸; Z= 1代表有高血壓、 Z= 0代表無高血壓。估計結果如下:
\[\exp(\beta_1) = \exp(0.69) \approx 2.00 \] \[ \exp(\beta_2) = \exp(0.92) \approx 2.51 \] \[ \exp(\beta_3) = \exp(0.41) \approx 1.51 \] \[ \exp(\beta_1 + \beta_2) = \exp(0.69 + 0.92) = \exp(1.61) \approx 5.00 \] \[ \exp(\beta_1 + \beta_3) = \exp(0.69 + 0.41) = \exp(1.10) \approx 3.00 \] \[ \exp(\beta_2 + \beta_3) = \exp(0.92 + 0.41) = \exp(1.33) \approx 3.78 \]
計算並回答:1.在無高血壓的樣本中,吸菸者罹患心血管疾病的 odds ratio;2.在有高血壓的樣本中,吸菸者與心血管疾病的 odds ratio;以及3.根據模式分析結果,是否支持吸菸與高血壓之間存在相乘尺度 (multiplicative)上的交互作用?(15 分)
二、某研究欲比較三種飲食介入方式對受試者三個月後體重(單位:公斤) 下降是否有不同效果。研究者將體重過重成人隨機分派至三組,每組 若干人,其中 A 組:低脂飲食;B 組:地中海飲食;C 組:低醣飲 食。研究結果顯示:A、B、C 組平均體重(單位:公斤)分別下降 3.2、5.6、6.1,其 One-way Analysis of Variance(ANOVA)分析結果 如下:
1.請寫出 One-way ANOVA 的虛無假設(Null hypothesis)與對立假設(Alternative hypothesis);2.進行此 One-way ANOVA 檢定時資料需要符合那一些假設?3.若研究者希望知道那兩組平均值彼此不同, 應再進行何種統計分析?請至少列舉一種適當的方法。(20 分)
三、某研究欲評估一項健康促進方案是否能改變規律運動習慣。共有 80 位受試者參加健康促進課程,並於介入前及介入後調查是否每週運動 至少 150 分鐘,研究結果如下:
在 α= 0.05水準下,請檢定健康促進方案是否能改變規律運動習慣? (註: \( \chi_{0.05,1}^2 \)= 3.84;\( \chi_{0.01, 1}^{2} \)= 6.63) 。請詳述:檢定假設、檢定統計量計算過程、p-value 數值範圍、統計決策以及結論。 (15 分)
 阿摩線上測驗
登入
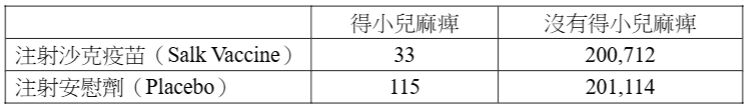 (A) 0.000164 (B) 0.000572 (C) 0.2875 (D) 0.3301
 (A)獨立雙樣本平均數檢定 (B)威爾考克森等級和檢定(Wilcoxon rank sum test) (C)威爾考克森符號等級檢定(Wilcoxon signed rank test) (D)成對樣本平均數檢定
 (A)因交互作用項的 p 值大於 0.05,故此模型不需考慮加入交互作用項 (B)因交互作用項的 p 值大於 0.05,故此模型需考慮加入交互作用項 (C)因交互作用項係數估計為-0.00668,小於 0,故此模型需考慮加入交互作用項 (D)因交互作用項係數估計為-0.00668,很接近 0,故此模型不需考慮加入交互作用項
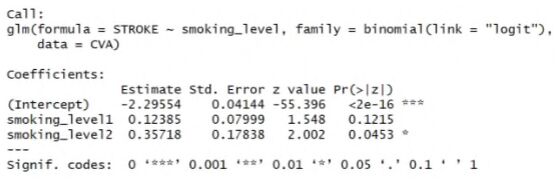 (A) 1.429 (B) 1.132 (C) 1.263 (D) 0.700
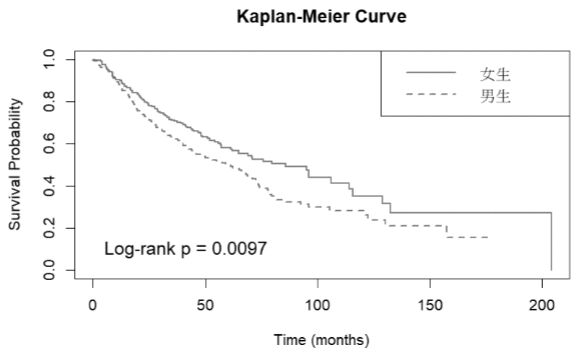 (A)圖中顯示在顯著水準=0.05 下,我們有充分證據證明男、女兩組平均存活天數具顯著差異 (B)圖中出現垂直向下的階梯(steps),代表該時間點有病患失聯或退出研究(設限資料) (C)圖中顯示所有的病患皆觀察到死亡事件發生 (D)此圖男性存活中位數大約為 59 個月,女性的存活中位數大約為 82 個月
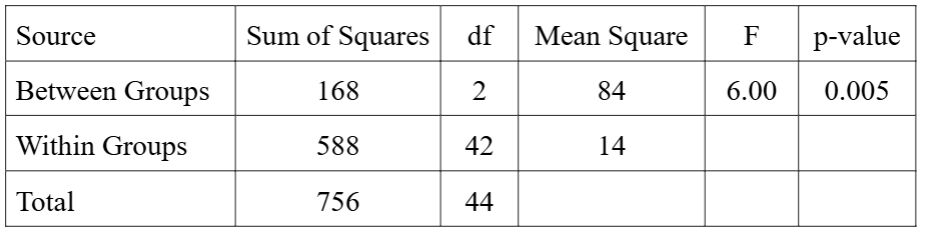 1.請寫出 One-way ANOVA 的虛無假設(Null hypothesis)與對立假設(Alternative hypothesis);2.進行此 One-way ANOVA 檢定時資料需要符合那一些假設?3.若研究者希望知道那兩組平均值彼此不同, 應再進行何種統計分析?請至少列舉一種適當的方法。(20 分)
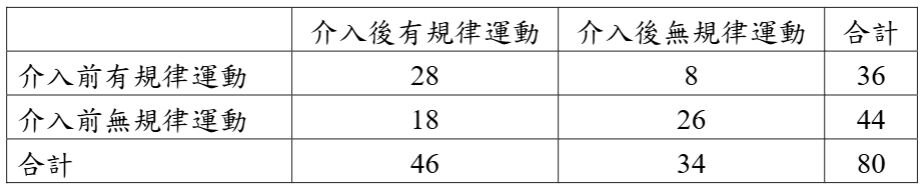 在 α= 0.05水準下,請檢定健康促進方案是否能改變規律運動習慣? (註: \( \chi_{0.05,1}^2 \)= 3.84;\( \chi_{0.01, 1}^{2} \)= 6.63) 。請詳述:檢定假設、檢定統計量計算過程、p-value 數值範圍、統計決策以及結論。 (15 分)