所屬科目:iPAS◆中級◆人工智慧技術應用與規劃
1. 某工程師正在建置一套法律文件解析系統,在進行資訊擷取(Information Extraction)前,需要對文本進行詞性標註(Part-of-Speech Tagging, POS Tagging)。 請問此步驟的主要目的為何? (A)將文本翻譯為其他語言以利跨語言分析; (B)將文本切分為基本詞彙單位,以便後續處理; (C)判斷文本中各詞彙的情感傾向; (D)為每個詞彙標記其語法類別,如名詞、動詞與形容詞
2. 一家新創公司希望對 Llama3 70B 模型進行領域微調(Domain Fine-Tuning)以建 立企業專用助理,但 GPU 記憶體有限,無法支撐完整模型的反向傳播梯度計算。 工程師希望凍結(freeze)原模型權重、僅訓練少量額外參數的前提下,評估採用 LoRA(Low-Rank Adaptation)方案。請問 LoRA 在此場景下的主要優勢為何? (A)透過知識蒸餾(Knowledge Distillation)將 70B 模型壓縮為較小的學生模型; (B)對原始模型各層權重進行剪枝(Pruning),移除低重要性參數後再進行微調; (C)凍結原始預訓練權重,僅在各層加入低秩分解的可訓練矩陣,大幅降低可訓練 參數量與 GPU 記憶體需求; (D)將模型中的注意力機制改為稀疏注意力(Sparse Attention),以降低長序列計 算成本
3. 某工程師在建構搜尋引擎的詞向量模型時,語料庫規模達數十億 token,且包含 大量長尾詞彙(Long-tail Terms)。他在 Word2Vec 的 CBOW 與 Skip-gram 兩種訓 練策略之間進行選擇,需考量訓練效率與低頻詞表示品質之差異。下列何者最能 準確地反映兩者在此情境下的取捨? (A)CBOW 對長尾詞表現更好,因為它透過多個上下文詞的平均來強化稀疏詞的 訓練訊號; (B)CBOW 訓練速度較快、整體語意平滑,但對低頻詞的向量品質較差;Skip-gram 以中心詞預測周圍詞,對長尾詞累積更多訓練樣本,向量品質較優; (C)Skip-gram 訓練速度更快,因為每次只需預測單一目標詞,計算量低於 CBOW; (D)兩者對低頻詞的表現完全相同,差異僅在於訓練時的 Batch 組織方式
4. 某金融科技公司的工程師正在準備內部客服對話與交易紀錄文本,進行 BERT 模 型的預訓練,以提升模型對金融語境的理解能力,並採用遮蔽語言建模(Masked Language Model, MLM)作為訓練任務。請問 MLM 的核心訓練目標為何? (A)讓模型自左至右逐 token 生成句子,學習自迴歸語言模型(Autoregressive LM) 能力; (B)透過對抗訓練(Adversarial Training)縮小真實句與生成句之間的語意差異;(C)隨機遮蔽輸入序列中部分 token,訓練模型根據雙向上下文預測被遮蔽的原始 內容; (D)透過遮蔽低頻詞來減少詞彙表大小,降低 Embedding 的記憶體使用
5. 某電商平台的工程師在開發商品評論情感分析系統時,發現使用 One-Hot 編碼無 法表達詞語之間的語意關係,且隨著詞彙表擴大,向量維度與記憶體需求快速增 加。工程師因此改用 Word2Vec 進行詞語表示。請問 Word2Vec 從根本上解決了 上述問題的哪項限制? (A)建立詞語之間的序列依賴關係,以捕捉長距離上下文語意; (B)根據詞語在語料中的出現頻率調整其重要性,使模型更重視高頻詞; (C)降低詞彙表示的維度,同時保留語意結構,避免高維稀疏表示所帶來的限制; (D)透過監督式學習利用標註語料,提升詞語分類的準確性
6. 某自駕車感知系統需要在同一張影像中同時完成道路、建築、行人的逐像素分類, 並且能夠區分畫面中兩名相鄰行人(標記為「行人#1」和「行人#2」)。工程師在 選擇語義分割(Semantic Segmentation)與實例分割(Instance Segmentation)時, 請問兩者的根本差異為何? (A)實例分割對每個像素進行分類但不產生 Bounding Box;語義分割產生 Bounding Box 但不進行像素級標記; (B)實例分割僅用於影像層級的類別分類,語義分割才進行逐像素標記; (C)語義分割將每個像素分配至預定義類別,但同一類別內的不同個體無法區分; 實例分割能對同一類別的不同物件(如兩名行人)分別建立獨立遮罩(Mask); (D)語義分割與實例分割皆為逐像素分類任務,但兩者在是否需要區分不同物件 個體上並無差異
7. 某大型超市的防損系統需要即時偵測多名顧客各自手持的購物籃、手機與商品, 並需對每個物件進行精確區域標記(Pixel-level Mask),同時能區分畫面中不同個 體(即使不同顧客拿著相同商品,也需分別標記)。請問下列哪一項技術最適合此 場景的需求? (A)影像分類(Image Classification); (B)目標檢測(Object Detection); (C)實例分割(Instance Segmentation); (D)語義分割(Semantic Segmentation)
8. 某工程師訓練了一個皮膚病變二元分類模型(惡性/良性),在向臨床醫師報告模型效能時,使用 ROC 曲線(Receiver Operating Characteristic Curve)進行呈現。 請問 ROC 曲線的橫軸(X 軸)與縱軸(Y 軸)分別代表哪些指標,且在醫療情境 中代表哪一種意義? (A)X 軸為準確率(Accuracy),Y 軸為召回率(Recall),表示模型整體分類正確 比例與偵測能力; (B)X 軸為假陽率(False Positive Rate, FPR),Y 軸為真陽率(True Positive Rate, TPR),反映誤診健康個體的風險與正確識別病患的能力; (C)X 軸為精確率(Precision),Y 軸為召回率(Recall),表示預測為陽性樣本的準 確性與完整性; (D)X 軸為 IoU 閾值,Y 軸為 mAP,反映物件偵測模型在不同重疊條件下的表現
9. 某團隊在監控影像分類模型的線上效能時,透過儀表板呈現混淆矩陣(Confusion Matrix),以觀察模型預測結果與實際標籤的分佈情形。請問下列哪一項無法從混 淆矩陣中直接計算? (A)精確率(Precision); (B)準確率(Accuracy); (C)召回率(Recall); (D)ROC 曲線下面積(AUC)
10. 某工廠導入即時影像瑕疵偵測系統,需在高頻影像流中進行快速推論。工程師在 YOLO 與 Faster R-CNN 兩種物件偵測架構之間進行評估,請問下列哪一個針對 兩者在偵測流程設計上的差異最為正確? (A)YOLO 採用單階段偵測,直接從整張影像預測物件位置與類別;Faster R-CNN 則先產生候選區域再進行分類; (B)YOLO 與 Faster R-CNN 皆採用兩階段流程,但在特徵擷取方式上有所不同; (C)YOLO 採用單階段架構,主要透過增加候選區域數量來提升偵測準確率; (D)Faster R-CNN 採用單階段偵測方式,將物件定位與分類整合於同一模型中
11. 某工程師在分析 Transformer 架構時,發現自注意力機制(Self-Attention)能夠有 效提升模型對序列中長距離依賴關係的建模能力。請問 Self-Attention 的核心功能 為何? (A)透過隱藏狀態的遞迴傳遞,逐步累積序列中的上下文資訊; (B)讓序列中每個 token 能與其他所有 token 建立關聯,並根據重要性分配權重; (C)對輸入序列進行局部運算,以捕捉相鄰詞之間的關係; (D)將整個序列壓縮為固定長度表示,以提供後續任務使用
12. 某工程師在設計一個二元分類器(Binary Classifier)時,考慮在輸出層使用 Sigmoid 函數。請問 Sigmoid 函數的主要特性與限制為何? (A)可將輸入轉換為任意實數範圍,適合用於迴歸任務; (B)可將輸入壓縮至(0, 1)區間,可解釋為機率值,但在輸入值過大或過小時可能 產生梯度消失問題; (C)可將輸入轉換為多類別機率分布,常用於多分類任務; (D)可在整個輸入範圍內梯度保持穩定,適合用於深層神經網路
13. 某公司評估兩種方案,將大型語言模型客製化為內部客服助理:方案 A 為提示微 調(Prompt Tuning),在輸入端加入可學習的軟提示(Soft Prompt);方案 B 為傳 統微調(Fine-Tuning),以標註問答資料調整模型。兩方案最本質的技術差異為 何? (A)提示微調主要用於降低推論延遲,而傳統微調則用於提升模型容量; (B)兩者技術本質相同,差別僅在於學習率(Learning Rate)設定不同; (C)傳統微調通常需要更新模型參數,而提示微調主要透過調整輸入表示來影響模 型行為; (D)提示微調與傳統微調的差異僅在於是否使用預訓練模型
14. 某工程師計劃將通用 LLM 在醫療問答語料上進行監督微調(Supervised FineTuning, SFT),但發生了災難性遺忘(Catastrophic Forgetting)問題。在計算資源 有限的情況下,工程師希望透過調整微調策略來緩解此問題。下列哪一種訓練設 計最能有效率地學習新任務的同時保留原有能力? (A)凍結大部分預訓練參數,僅對少量新增模組(如 LoRA 層)進行微調,並控制 更新範圍以減少對原有知識的干擾; (B)提高學習率(Learning Rate)並縮短訓練步數,使模型快速收斂至新任務,避 免長時間訓練造成遺忘; (C)僅使用醫療語料進行多輪訓練,強化模型對新任務的專注程度; (D)增加批次大小(Batch Size)以穩定梯度更新,使模型同時保留舊知識與學習 新知識
15. 某企業建置一套多代理人(Multi-Agent)系統,由一個 Orchestrator Agent 負責任 務分配,多個 Worker Agent 分別執行網路搜尋、程式撰寫與結果彙整。若 Orchestrator 發現某 Worker Agent 回傳結果品質不符合預期,從系統容錯與任務 可靠性角度,下列哪一項機制最能確保整體任務仍能正確完成? (A)直接採用該 Worker Agent 的輸出,避免重試機制造成延遲; (B)Orchestrator 具備結果評估能力,對不合格結果觸發重試(Retry)或重新分配 給不同 Worker,並記錄失敗原因供後續改善; (C)強制所有 Worker Agent 統一使用相同的 LLM 模型,以減少輸出差異; (D)當任何一個 Worker 失敗時,整個 Multi-Agent 任務直接中止並通知使用者重 新啟動
16. 一位工程師正在實作一個 ReAct 框架的 AI Agent,該 Agent 需要回答「台灣目前 最大的電動車充電站營運商是哪間公司,以及其充電樁總數」。 Agent 的工具清單如下: •web_search(query):回傳搜尋結果摘要 •get_webpage(url):回傳網頁內文 •calculator(expression):回傳計算結果•get_current_date():回傳今日日期工程師設計了以下的 System Prompt 與 ReAct Loop,請問此 Agent 設計存在哪些問題?應如何改善?[System Prompt] 你是一個資料查詢助理。 每次只能使用一個工具。 當你知道答案時,直接輸出最終答案。[第一輪 Agent 輸出] Thought: 我已經知道台灣電動車市場的概況,不需要搜尋,可以直接回答。Action: 無 Answer: 台灣最大充電站營運商是 XX 公司,共有 500 個充電樁。 (A)System Prompt 未要求 Agent 在回答前使用工具驗證,導致直接依賴既有知識 產生幻覺(Hallucination);應明確規定即時性問題需先執行 web_search; (B)工具清單提供了 calculator 與 get_current_date,屬於多餘工具,可能增加 Agent 的選擇複雜度; (C)ReAct 框架的核心問題在於 Thought 步驟佔用過多 token,應移除 Thought 欄 位,直接讓 Agent 輸出 Action,以提升推理效率; (D)Agent 應在第一輪就呼叫所有可用工具並彙整結果,避免多輪 Loop 造成的延 遲
17. 某醫療新創公司正在開發一套「多模態患者風險評估系統」,需同時處理三種異質 資料來源:胸腔 X 光影像(影像模態)、臨床診斷筆記(文字模態),以及心率與 血氧的時序感測資料(數值時序模態)。工程師在進行各模態的特徵擷取模型選擇 時,需為每種模態挑選最適合的模型架構。下列哪一組模型配置最符合三種模態 各自的資料特性? (A)影像模態用 LSTM、文字模態用 CNN、時序模態用 BERT; (B)影像模態用 TF-IDF、文字模態用 ResNet、時序模態用 Word2Vec; (C)三種模態統一使用 BERT,因為 Transformer 架構具備通用性,可處理任意形 式的輸入資料; (D)影像模態用 CNN、文字模態用 Transformer、時序模態用 LSTM 或 Temporal CNN
18. 某醫院的 AI 研究團隊正在開發一套整合「CT 影像+電子病歷文本+基因序列」三 種模態資料的癌症預測模型。請問在此場景中採用「跨模態對齊(Cross-Modal Alignment)」技術主要解決什麼問題? (A)使模型僅聚焦於 CT 影像資料,避免文本與基因資料引入雜訊; (B)自動生成跨模態配對標註,以減少人工標記需求; (C)降低多模態資料的儲存與計算成本,以提升訓練效率; (D)將不同模態的資料表示對齊至共同語意空間,使模型能建立跨模態之間的語意關聯
19. 一家電商公司已將推薦系統 AI 模型上線三個月,業務主管要求專案團隊評估導入成效。團隊根據下圖數據得出結論:「因為 AUC 高達 0.91,模型表現優異,AI 導入成效良好。」請問此評估結論存在什麼根本問題? (A)僅依賴離線指標 AUC 判斷模型成效,忽略線上業務指標(如 CTR 與營收) 的變化,可能導致錯誤結論; (B)AUC 已達 0.91,代表模型排序能力優異,即使 CTR 略為下降,仍可視為推薦 品質提升; (C)CTR 從 3.2%降至 3.1%,顯示模型效果變差,應立即還原(Rollback)至舊模 型; (D)平均訂單金額提升至$1,020,代表模型已成功優化營收,因此無需考慮其他指 標
20. 某電商公司計畫導入即時推薦系統,希望使用者進入網站後能在 100 毫秒內取得 推薦結果,且推薦結果需依據最新使用者行為進行調整。系統需支援每日約 50 萬 活躍使用者,尖峰時段每秒約 3,000 筆請求(QPS)。目前公司已累積歷史購買紀 錄與瀏覽行為資料,並持續接收即時點擊流(Streaming Data)。IT 基礎架構採用 雲端環境,團隊配置為 2 名資料工程師與 1 名機器學習工程師。某工程師提出以 下導入規劃:(1)使用批次訓練(Batch Training)建立協同過濾模型(2)將模型部署為 REST API 提供即時推論服務(3)使用 Kafka 串流處理即時使用者行為特徵 (4)將所有即時資料先寫入資料倉儲(Data Warehouse)再進行特徵計算(5)使用 Redis 或 Feature Store 快取即時特徵 請問以下哪一項最合理的技術導入規劃組合與調整建議? (A)保留(1)(2)(3),移除(4),並加入(5)以降低延遲; (B)保留(1)(4),移除(3),以確保資料一致性與系統穩定; (C)保留(2)(4)(5),移除(1),改用即時線上學習(Online Learning); (D)全部保留(1)~(5),可同時兼顧即時性與資料完整性
21. 一位機器學習工程師正在優化公司內部的 RAG 法律文件問答系統。近期因營運 成本壓力,公司要求在不更換模型且不影響回答品質的前提下,將整體 token 成 本降低至目前的 60%,且目前成本主要集中於輸入 tokens。工程師在檢查系統後, 盤點出目前的使用情況如下: ◆使用模型:GPT-4o(輸入$5/1M tokens、輸出 $15/1M tokens) ◆每次查詢:將前 10 筆檢索文件區塊全部加入 Prompt(每塊約 600 tokens) ◆System Prompt:每次請求均包含約 500tokens 的公司背景說明 ◆對話機制:保留完整對話歷史,平均累積約 8,000tokens◆每日查詢量:約 5,000 次 ◆平均輸出:約 300tokens/次 在上述限制與系統現況下,請問下列哪一項優化組合,最能在維持回答品質的前提下有效降低 token 成本? (A)將輸出 max_tokens 從 1,000 壓縮至 200,強制模型給出更短的回答,以降低輸 出費用; (B)將 System Prompt 改為 Prompt Caching 或靜態前綴重用,並對對話歷史實作摘 要壓縮,以保留語意而非完整對話; (C)將所有查詢改為 Batch API 模式送出,透過非同步處理降低單次費用; (D)在 Prompt 中明確要求模型「回答時盡量簡短」,透過指令引導模型自行縮減輸 出長度
22. 某金融科技公司計劃建立完整的 AI 開發到維運流程,希望實現「模型訓練→測 試→部署→監控→再訓練」的自動化流程串接,並確保線上模型的版本可追溯。 技術主管建議引入 MLOps 框架。MLOps 在此 AI 開發生命週期中的核心角色為 何?(A)專注於訓練資料的標註與品質控管,以提升模型訓練效果; (B)透過自動化模型搜尋與參數調整,降低模型開發門檻; (C)建立機器學習流程的自動化與版本管理機制,支援模型部署、監控與持續更新; (D)確保模型在部署後維持穩定效能,減少後續維運與更新需求
23. 某製造業公司計劃將 AI 導入生產線瑕疵檢測流程,目前瑕疵樣本約 800 張(含 各類瑕疵類型)、正常樣本約 15,000 張,現有 IT 基礎設施為地端伺服器且無 GPU, 且生產線環境需於地端即時完成推論,檢測需求為每片零件須在 100 毫秒內完成 檢測,且預算為中等、無法於短期內大規模採購硬體。工程師正在規劃第一階段 的 AI 導入方案,請問下列哪一種規劃最為合適? (A)從零訓練一個大型 CNN 模型,並採購高階 GPU 伺服器以滿足推論速度需求; (B)採用預訓練模型進行 Transfer Learning,針對瑕疵樣本進行 Fine-tuning,並使 用模型量化(Quantization)或蒸餾(Distillation)技術壓縮模型以符合延遲需求, 部署於地端; (C)因樣本數不足,建議先暫緩 AI 導入,待蒐集至少 10 萬筆瑕疵樣本後再啟動 專案; (D)將所有影像上傳至雲端,使用第三方 AutoML 平台自動訓練並部署,以節省開 發時間
24. 某即時詐欺偵測系統對模型回應時間有嚴格限制,若推論延遲過高將影響交易核 准流程。維運工程師在模型上線前進行延遲測試(Latency Testing)時,主要評估 的目標為何? (A)評估模型推論過程中的記憶體使用量,以確認部署資源是否足夠; (B)驗證模型對異常或攻擊輸入的穩定性與安全性; (C)評估模型在不同使用者族群上的預測結果是否一致; (D)評估模型從接收輸入到產生預測結果所需的回應時間是否符合系統要求
25. 某企業欲將其 AI 輔助決策系統提交給外部稽核單位審查,並宣稱符合 NIST《AI 風險管理框架》(NIST AI RMF)中可驗證性(Verifiability)的要求。為讓第三方 稽核人員能獨立重現模型評估結果,下列哪一項技術實踐最直接符合此要求? (A)將模型測試準確率優化至 99%以上,以達到業界公認的高可靠標準; (B)建立可追溯的測試資料與評估流程,並記錄模型訓練與評估過程中的關鍵設 定,以確保結果可被重現; (C)加快模型迭代速度,縮短版本發布週期以盡快累積外部驗證數據; (D)擴充訓練資料量至數百萬筆,以統計方式確保模型的泛化能力達標
26. 某銀行導入一套 AI 授信審核系統,針對貸款申請人進行自動化決策。監理單位 要求系統必須符合負責任 AI(Responsible AI)原則,特別是對被拒絕的申請人提供每筆決策的具體理由說明。從技術與合規的角度,此要求的核心能力需求為 何? (A)系統必須在收到申請後 10 秒內自動刪除申請人個資; (B)系統應隨機調整部分決策以確保多元性; (C)系統必須保證所有決策準確率達到 100%; (D)系統必須具備可解釋性(Explainability)能力,能提供特徵貢獻說明
27. 某醫院計劃導入一套 AI 醫療影像診斷輔助系統,用於輔助放射科醫師判讀 CT 影 像。院方技術委員會討論在人命攸關且需確保最終臨床決策責任由人類承擔的情 境下,從系統設計架構層面,最關鍵的安全機制為何? (A)採用人機協作(Human-in-the-Loop, HITL)架構,由醫師最終審核決策; (B)模型信心低於閾值(Threshold)即自動關機; (C)隨機切換模型並以多數決決策; (D)對輸入影像加入隨機擾動
28. 一位資料科學家使用 XGBoost 建立信用風險評分模型,並使用 SHAP 解釋模型 對某申請人的預測結果。SHAP summary plot 顯示該樣本中「月收入」的 SHAP 值 為-2.3,「負債比率」為+1.8,其中 SHAP 值代表各特徵對模型輸出值的影響程度 與方向。關於對 SHAP 值的解讀,下列敘述何者正確? (A)「月收入」的 SHAP 值-2.3 代表該特徵使此申請人的違約預測機率降低了 2.3%; (B)「月收入」的 SHAP 值-2.3 代表相對於基準值(base value),此特徵將模型輸 出值往負方向推移了 2.3 個單位,表示月收入對該申請人有降低違約風險的貢獻; (C)SHAP 值為負代表該特徵對模型整體來說是不重要的特徵,應考慮從模型中移 除; (D)負債比率」SHAP 值+1.8 代表負債比率是整個訓練集中對違約影響最大的特徵
29. 某工程師為一套卷積神經網路(CNN)的醫療影像輔助診斷系統設計模型可解釋性機制。該系統需滿足下列需求:1.能向醫師說明影像被判定為異常的原因 2.支援近即時推論,每次解釋須於 200 毫秒內完成,且不可進行大量重複採樣計算 3.解釋結果須以影像中具代表性的視覺化像素區域呈現在此情境下,下列何種方法最為適合? (A)使用 LIME,透過超像素擾動取樣分析影像區塊對預測的影響; (B)使用 SHAP KernelExplainer,計算各像素的 Shapley 值並疊加於原始影像; (C)使用 Grad-CAM(Class Activation Map),透過梯度反向傳播生成類別關注區 域; (D)使用 SHAP TreeExplainer,計算特徵貢獻並以熱力圖呈現
30. 某資料科學家正在處理一份包含 200 個感測器特徵的工廠設備監測資料集,為了 降低模型複雜度並保留主要變異資訊,他先對資料進行標準化(Standardization), 再使用主成分分析(PCA)進行降維。在 PCA 過程中,為了找出能最大化資料變 異量的主成分方向,演算法主要依賴哪一項數學操作? (A)透過對目標函數進行梯度下降(Gradient Descent)最佳化,迭代求得主成分方 向; (B)根據特徵與目標變數之間的相關性(Correlation)進行排序,選擇重要特徵; (C) 對 資 料 的 協 方 差 矩 陣 ( Covariance Matrix ) 進 行 特 徵 值 分 解 ( Eigen Decomposition),取得對應主要變異方向的特徵向量; (D)對資料矩陣進行卷積運算(Convolution),擷取特徵之間的局部關係
31. 某資料工程師嘗試對包含 300 個特徵的使用者行為資料集使用 DBSCAN 進行群 集分析,但發現幾乎所有資料點都被判定為雜訊點(Noise Points),難以形成有 意義的群集,即使不斷調整ε(Epsilon)與 MinPts 參數也無濟於事。請問下列何 者為此問題最可能的根本原因? (A)在高維空間中,維度詛咒(Curse of Dimensionality)使得資料點之間的距離趨 於相近,導致 DBSCAN 的密度估計失效; (B)DBSCAN 演算法僅適用於低維資料,無法處理高維資料; (C)300 個特徵的資料必然不具備群集結構,因此無法進行有效的分群; (D)高維空間中核心點的數量會受到數學限制,導致無法形成群集
32. 某工程師正在實作一個 CNN 影像分類模型,在 PyTorch 中定義模型架構時,需 要在卷積擷取特徵後接上全連結層(Fully Connected Layer)進行分類。在模型程 式碼中,需要在卷積輸出與全連結層之間插入什麼操作? (A)使用全域平均池化(Global Average Pooling)將特徵圖壓縮後再接全連結層; (B)使用 Flatten 將特徵圖展平成一維向量; (C)直接將卷積輸出接到全連結層,系統會自動轉換維度; (D)先對特徵圖做 Softmax,再輸入全連結層
33. 某自駕車公司的 AI 訓練團隊面臨標註成本高的問題,無法取得足夠的真實惡劣 天氣(大雨、濃霧)駕駛場景資料,工程師提議使用合成資料(Synthetic Data) 來補充訓練集。請問下列何者最能正確敘述合成資料在 AI 訓練中的角色? (A)合成資料主要用於文字任務的資料擴增,影像任務仍需依賴真實資料; (B)合成資料可完全取代真實資料,直接用於模型訓練; (C)合成資料主要用於降低模型推論時的計算成本; (D)合成資料可在控制條件下產生多樣化場景,用於擴充訓練資料並提升模型的
34. 某廣告技術公司的點擊率(CTR)預測系統每天新增數百個用戶行為特徵(如新 廣告位、新設備類型),特徵空間持續動態擴展。若採用傳統靜態模型每週批次重 訓一次,會導致嚴重的模型過期問題。為在特徵空間頻繁變化的情況下維持模型 即時準確度,最適合的模型架構方向為何? (A)採用傳統靜態羅吉斯迴歸(Logistic Regression),縮短批次重訓週期從每週改 為每日; (B)採用支援增量學習(Incremental Learning)的模型,使模型能隨新資料即時更 新並適應新增特徵,而不需重新訓練整個模型; (C)採用固定架構的深度神經網路(DNN),每次有新特徵時重新定義輸入層後全 量重訓; (D)改用預訓練圖神經網路(GNN),透過圖結構建立特徵間的關聯,自動應對新 增特徵
35. 某生物醫學研究機構正在建構一個整合「基因序列特徵」與「電子病歷文本特徵」 的疾病風險預測模型。由於高維數值特徵和語意文本特徵的性質差異顯著,請問 下列哪一種特徵處理與選擇策略最為合適? (A)將所有特徵合併為單一特徵矩陣後,使用主成分分析(PCA)進行降維,作為 模型輸入; (B)採分層策略,先對基因序列特徵進行特徵選擇,再對文本特徵進行語意表示, 最後將兩類特徵融合(Feature Fusion)後輸入模型; (C)將所有特徵合併後,使用隨機森林(Random Forest)的特徵重要性進行一次性 排序與篩選; (D)將文本特徵轉換為簡單統計特徵(如詞頻)後與基因特徵一併建模,以降低特 徵處理複雜度
36. 某公司希望開發一個工業零件瑕疵辨識分類模型,共有 10 個類別,但每類僅約 50 張人工標註影像(總計約 500 張)。由於標註成本高昂,短期內無法擴充資料 集。在此情境下,工程師需要在有限標註資料下建構高效能模型。請問下列哪一 種策略最為適合? (A)使用在大型資料集預訓練完成的卷積神經網路(CNN),並進行遷移學習微調; (B)從頭訓練大型 Vision Transformer(ViT),完全使用現有 500 張影像; (C)使用 K-means 對影像進行分群,並直接將群集結果作為分類模型輸出; (D)複製既有的資料以增加標註影像數量,並從頭訓練深度 CNN 模型
37. 某製造廠開發產線瑕疵檢測模型時,資料集存在嚴重類別不平衡問題,其中良品 約占 99%,瑕疵品僅占 1%。若直接使用原始資料進行訓練,模型容易偏向預測多數類別(良品),導致對少數類別(瑕疵品)辨識能力不足。在不調整模型架構 與學習演算法的前提下,僅透過資料前處理方式改善此問題,下列何者最適當? (A)使用 SMOTE 等過採樣方法進行少數類別擴增; (B)加入 L1/L2 正則化(Regularization)以防止過擬合; (C)大幅增加深度神經網路的層數,以強化特徵萃取能力; (D)複製更多良品數據,以進一步提升模型的準確率(Accuracy)
38. 某 IoT 平台接收工廠溫度感測器資料,發現在常態分佈(均值 25°C,標準差 2° C)的數萬筆紀錄中,出現數筆「999°C」的極端值,研判為感測器通訊錯誤(網 路封包延遲導致數值溢位)所致,且該異常數值在實際情況下不可能發生。在進 行模型訓練前的資料清洗階段,針對這類離群值,最適當的處理策略為何? (A)保留所有原始數值,並使用平均數(Mean)作為特徵輸入模型; (B)對數據進行 Z-score 標準化,使數值落於約[-3, 3]範圍; (C)將 999°C 以獨熱編碼(One-Hot Encoding)轉為獨立類別特徵; (D)刪除異常的 999°C 記錄,或以中位數(Median)進行填補
39. 某 AI 平台工程師正在為多模態模型訓練系統規劃資料儲存架構,需要同時處理 原始影像、非結構化文本,以及經過整理的結構化特徵資料。在此情境下,應如 何選擇資料湖(Data Lake)與資料倉儲(Data Warehouse)的使用方式? (A)將原始影像與文本資料儲存在 Data Lake,將整理後的結構化特徵資料儲存在 Data Warehouse; (B)將所有資料統一儲存在 Data Warehouse,以提升查詢效率; (C)將所有資料統一儲存在 Data Lake,但犧牲結構化資料的查詢效率; (D)僅將原始影像資料儲存在 Data Lake,其餘資料統一存入 Data Warehouse
40. 某智慧製造公司在產線上部署工業相機進行即時外觀瑕疵檢測,原先將影像傳至 雲端進行 AI 推論,但因網路延遲與連線不穩導致系統無法滿足即時需求(需低 於 200ms)。工程師因此改為將模型部署於產線端的邊緣裝置後,但仍未達系統需 求。在不更換硬體設備的前提下,下列哪一組技術最能有效降低推論延遲,同時 維持合理準確率? (A)減少訓練資料的使用數量,並重新訓練模型以提升推論效率; (B)使用批次推論(Batch Inference)處理多張影像以提升計算效率; (C)採用模型集成(Model Ensemble),透過多模型投票提升準確率; (D)將模型由 FP32 量化為 INT8,並進行推論加速優化
41. 某 AI 影像辨識平台以單一 GPU 伺服器提供多租戶推論服務,系統長期觀察到 GPU 使用率約維持在 60%左右,且在執行過程中可觀察到 GPU kernel 之間存在 明顯閒置間隔,單次推論多以小批次方式執行。然而,在尖峰時段時,請求延遲會出現明顯波動甚至突增。同時,CPU 與記憶體資源使用率均未達瓶頸,且系統 團隊已排除硬體、網路與請求併發控制異常。在此情境下,請判斷最可能造成問 題的原因為何? (A)GPU 排程策略與批次大小設定不當,導致 GPU 運算單元未被有效利用; (B)請求併發控制機制不佳,導致多個請求同時搶占 GPU Context 資源造成延遲; (C)GPU 硬體效能不足,無法支撐推論負載; (D)模型未進行量化優化,導致推論計算成本過高
42. 某保險公司將理賠金額預測模型正式部署上線,MLOps 團隊設計監控機制。三個 月後模型整體均方根誤差(RMSE)無明顯變化,但業務單位反映高額理賠案件 的預測誤差明顯增加。經分析,高額理賠案件僅佔約 5%的樣本比例,且未被監 控機制及時發現。請問最可能的設計缺陷為何? (A)監控頻率不足,應由每日批次監控改為即時串流監控; (B)高額理賠案件屬於長尾分布,難以透過監控指標偵測,因此無法透過監控機制 發現問題; (C)RMSE 無法有效反映高額誤差,應改以平均絕對誤差(MAE)作為主要監控指 標; (D)僅監控整體 RMSE,未針對不同理賠金額區間進行分群監控
43. 某電商平台的演算法工程師開發了一個新版商品推薦模型,在離線 A/B 測試中, 新模型的各項評估指標(AUC、NDCG@10)均顯著優於現行線上模型。然而, 離線測試無法完全反映真實使用者的互動行為(點擊、購買、停留時間)。在正式 全面上線前,若希望在可控制風險下量化真實業務指標,應採用下列何種線上驗 證策略? (A)影子模式(Shadow Mode):新舊模型同時產生預測,但僅顯示舊模型結果, 於後端比較輸出差異; (B)回測(Backtesting):使用歷史日誌模擬模型表現作為上線依據; (C)金絲雀發布(Canary Release):將 1–5%使用者流量導向新模型,量測 CTR、 CVR 等指標並逐步擴量; (D)負載測試(Load Testing):於測試環境進行高流量壓力測試後直接全面上線
44. 某 MLOps 工程師正在設計 AI 模型的推論服務 API,需要處理使用者上傳的高解 析度影像(平均 5MB)進行即時分類。在 RESTful API 設計時,選擇 HTTP 請求 方法與資料傳輸格式的最佳實踐為何? (A)使用 HTTP GET 方法,將影像資料 Base64 編碼後附加於 URL Query String 中; (B)採用 HTTP POST 請求,將影像資料以 multipart/form-data 或 application/octet- stream 傳輸於 Request Body; (C)使用 HTTP PUT 方法,透過 Content-Type: application/xml 傳遞影像資料; (D)要求客戶端下載模型於本地推論,僅回傳分類結果
45. 某 AI 平台整合多個外部 AI 微服務(語音辨識 API、NLP 分析 API、知識圖譜查 詢服務),在高峰期間某外部服務偶發延遲或逾時(Timeout),導致請求鏈路壅塞, 最終造成平台級服務中斷(Cascading Failure)。為從架構層面預防此類連鎖故障, 最有效的設計模式為何? (A)將所有外部 API 呼叫改為同步串行處理,並取消逾時限制,確保每個請求皆 完成後再繼續; (B)為外部服務導入斷路器模式(Circuit Breaker),在異常時暫停呼叫並提供替代 回應; (C)擴充各微服務的執行緒池(Thread Pool)上限,以提升併發處理能力; (D)停用服務健康檢查,減少不必要的額外負載
46. 某醫院計劃建立混合雲 AI 平台:使用公有雲 GPU 叢集進行 CT 影像模型訓練, 但基於 HIPAA(Health Insurance Portability and Accountability Act)法規要求,患 者影像原始資料不得離開醫院院內環境。下列何者最符合「利用公有雲算力訓練 模型」與「不傳輸原始患者資料」雙重限制的技術方案? (A)將患者影像資料以 AES-256 加密後上傳至公有雲,並於雲端解密後進行模型 訓練; (B)在院內部署同態加密(Homomorphic Encryption)模組,對推論請求進行加密 處理; (C)採用聯邦學習(Federated Learning)於院內訓練模型,僅傳送模型更新至雲端 聚合,原始資料不外流; (D)建立專線 VPN 連接醫院與雲端,以網路層安全保護資料傳輸
47. 某電商平台將新的推薦模型部署至線上系統,為降低風險,團隊採用漸進式部署 策略(Phased Rollout),先將新模型流量從 5%逐步提升至 100%。在部署初期, 團隊發現轉換率(Conversion Rate)略有提升,但在流量提升至 30%時,系統延 遲(Latency)明顯上升,且部分使用者體驗變差。請問在此情境下,最適當的下 一步策略為何? (A)立即將新模型全面部署至 100%,以觀察整體效果並評估系統表現變化; (B)還原(Rollback)至舊模型並停止新模型測試流程,以確保系統穩定與使用者 體驗品質; (C)維持目前 30%流量並持續觀察,即使延遲問題存在也暫不進行調整; (D)暫停流量提升,針對延遲問題進行效能分析與優化後再繼續部署
48. 某銀行的信用卡風控模型已穩定上線一年,主要用於偵測盜刷交易提醒。近期在 未對模型或特徵工程進行調整的情況下,系統觀察到深夜電商交易的核准率明顯 上升,盜刷攔截率下降,但模型 AUC 幾乎維持不變,且交易金額、地區與裝置 等特徵分布未出現明顯變化。進一步分析發現,疫情後使用者行為改變,使原本 被視為高風險的交易型態逐漸轉為一般消費。下列何者最能敘述此現象的原因? (A)資料漂移(Data Drift),因輸入特徵分布發生變化; (B)訓練與服務偏差(Training-Serving Skew),因線上與離線特徵處理不一致; (C)概念漂移(Concept Drift),因特徵與目標標籤之間的關聯性改變; (D)決策閾值偏移(Threshold Shift),因分類門檻設定不當導致預測偏差
49. 某零售電商平台已建立模型監控儀表板,用於追蹤線上推薦模型的運作狀態與效 能表現。 維運工程 師需判斷 哪些指標 屬於「線 上持續監 控( Continuous Monitoring)」的範疇。下列指標中,哪一項最不適合在即時監控系統中追蹤,而 應改由離線實驗追蹤系統管理? (A)訓練實驗中每個 Epoch 的學習率(Learning Rate)變化曲線與超參數 (Hyperparameter)設定軌跡; (B)線上推論 API 的 P50/P95/P99 回應延遲與每日請求量(RPS)趨勢; (C)輸入特徵分佈的族群穩定性指數(Population Stability Index, PSI),偵測資料漂 移; (D)模型預測結果分佈(如 CTR)與定期回收的人工標註結果之對比
50. 某醫療團隊建立肺炎診斷系統,採用晚期融合(Late Fusion)策略,將胸腔 X 光 影像與病患問診文字分別進行預測後再整合結果。測試發現,當問診紀錄品質不 佳(如描述簡短或資訊缺漏)時,整體模型效能僅小幅下降。關於此現象,下列 何者最不可能為其原因? (A)各模態獨立進行預測,可降低單一模態品質不佳對整體結果的影響 (B)融合階段可調整不同模態的權重,使低品質模態影響降低 (C)各模態使用獨立模型,使錯誤不會在特徵層被放大 (D)晚期融合會在輸入階段整合多模態特徵,因此能避免低品質資料影響
 阿摩線上測驗
登入
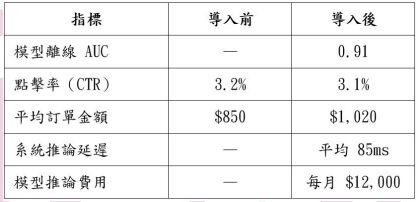 (A)僅依賴離線指標 AUC 判斷模型成效,忽略線上業務指標(如 CTR 與營收) 的變化,可能導致錯誤結論; (B)AUC 已達 0.91,代表模型排序能力優異,即使 CTR 略為下降,仍可視為推薦 品質提升; (C)CTR 從 3.2%降至 3.1%,顯示模型效果變差,應立即還原(Rollback)至舊模 型; (D)平均訂單金額提升至$1,020,代表模型已成功優化營收,因此無需考慮其他指 標