所屬科目:iPAS◆中級◆機器學習技術與應用
1. 某量化投資團隊需估算某投資組合未來 30 日的風險值。由於衍生性金融商品的 定價模型過於複雜,無法以解析解直接求得,工程師因此採用隨機模擬方式,產 生大量市場情境模擬並估計損失分布。此方法屬於下列哪一種技術框架? (A)馬可夫鏈(Markov Chain):以狀態轉移機率描述系統演變的隨機過程; (B)梯度下降最佳化(Gradient Descent):透過迭代更新參數以最小化損失函數; (C)蒙地卡羅方法(Monte Carlo Method):透過大量隨機抽樣近似機率分布或數值 結果; (D)貝氏推論(Bayesian Inference):結合先驗分布與資料更新後驗機率
2. 某工程師在建立房價預測模型時,訓練資料中存在少數豪宅(成交價超過一般物 件 10 倍以上)。若工程師希望模型對這些極端高價物件的預測誤差更敏感,並在 訓練時產生較大的梯度更新影響,應優先選擇下列哪種損失函數? (A)平均絕對誤差(MAE):對誤差進行線性懲罰,對離群值較不敏感,梯度近似 固定; (B)Huber 損失(Huber Loss):小誤差採平方懲罰,大誤差轉為線性懲罰,以降低 離群值影響; (C)均方誤差(MSE):對誤差進行平方處理,使大誤差產生更大的懲罰與梯度; (D)交叉熵損失(Cross-Entropy Loss):用於分類問題的機率分布差異衡量
3. 某工程師在撰寫 Transformer 的 Attention 層時,需手動驗證矩陣維度是否相容。 輸入矩陣 Q 已攤平成形狀為(1, 10),Query 投影權重矩陣 WQ形狀為(10, 64)。執 行 Q x WQ後輸出的形狀為何? (A)(1, 64); (B)(10, 10); (C)(64, 1); (D)維度不相容,無法相乘
4. 某 AI 團隊同時開發多個影像辨識系統,並在訓練流程中統一加入資料擴增策略 (包含隨機水平翻轉)以提升模型泛化能力。實驗後發現,部分任務的測試表現 明顯下降。下列哪一項任務最可能因該資料擴增策略引入語意錯誤(Semantic Inconsistency),使同一樣本在翻轉後對應不同類別標籤,進而影響模型學習? (A)寵物監控中的貓狗分類; (B)車輛辨識中的車型分類; (C)手寫數字辨識; (D)道路場景中的行人偵測
5. 某工程師完成多元線性迴歸模型後,繪製殘差圖(Residual Plot),發現殘差隨預測值增大而呈現擴散現象(右側明顯比左側分散)。此現象最可能代表什麼問題? (A)殘差之間存在關聯; (B)特徵之間高度相關; (C)殘差變異數不一致; (D)殘差不符合常態分布
6. 某資料科學家欲對 512 維詞嵌入向量(共 10 萬筆)進行視覺化以探索群集結構, 同時另一工程師需將 200 個製程特徵降維後作為 XGBoost 的輸入特徵。關於 tSNE 與 PCA 選型,下列敘述何者最正確? (A)t-SNE 保留全局線性結構,適合作為 XGBoost 的降維前處理; (B)t-SNE 保留局部鄰域結構,適合視覺化;但不保留全局結構,不適合作為模型 輸入特徵; (C)PCA 為非線性降維方法,能保留複雜流形結構; (D)t-SNE 與 PCA 皆可直接對新資料進行線性外推
7. 某金融團隊建立信貸風險模型,特徵工程後共產生 200 個變數,其中「月收入」、 「年收入」、「季收入」三者高度相關。模型上線後業務單位反映:每次重新訓練 後,模型輸出的重要特徵清單在這些高度相關特徵間反覆變動,難以向審查單位 解釋。請問下列何者為造成此現象最可能的原因? (A)模型使用 L2 正則化,導致所有特徵係數被壓縮至接近零,重要性難以區分; (B)模型使用 L1 正則化,面對高度相關特徵時隨機保留其中之一,導致每次訓練 保留的特徵不穩定; (C)模型未使用任何正則化,過擬合導致係數每次收斂至不同極值; (D)特徵數量過多導致梯度消失,應優先進行 PCA 降維再套用正則化
8. 某深度學習工程師訓練 ResNet 時,發現模型在前幾個 Epoch 驗證損失快速下降, 但從第 15 個 Epoch 起驗證損失開始上升,而訓練損失持續下降。工程師將學習 率調高後,訓練損失反而開始明顯震盪。學習率過大最直接導致下列哪種現象? (A)梯度消失(Gradient Vanishing):梯度在反向傳播中逐層縮小趨近於零,底層 無法學習; (B)損失函數震盪或發散(Oscillation / Divergence):每次更新步伐過大,參數在 最優點兩側反覆跳越,無法穩定收斂; (C)過擬合(Overfitting):模型記憶訓練資料的雜訊,泛化能力下降; (D)死亡 ReLU(Dying ReLU):大量神經元輸出永久為零,停止參與梯度更新
9. 某工程師訓練深度神經網路時發現損失函數震盪嚴重且收斂速度慢,改用 Adam 優化器後訓練變得穩定且收斂更快。下列何者為 Adam 能改善此問題的主要原 因? 115 年第一次 AI 應用規劃師-中級能力鑑定【公告試題】 第三科:機器學習技術與應用 考試日期:115 年 05 月 23 日 第 3 頁,共 18 頁 答案 題目 (A)同時結合一階動量(Momentum)與自適應學習率(Adaptive Learning Rate), 為每個參數調整更新步長; (B)強制所有參數使用相同學習率(Learning Rate),避免梯度差異造成不穩定; (C)透過批次正規化(Batch Normalization)重新分布輸入資料; (D)將梯度裁剪為固定範圍以避免梯度爆炸(Gradient Explosion)
10. 某工程師同時開發兩個模型:一個預測使用者「隔日 App 使用時長(分鐘)」,另 一個預測使用者「隔日是否流失(是/否)」。關於上述兩個任務,他應分別選擇哪 種適當的損失函數? (A)使用時長預測:均方誤差(MSE);流失預測:二元交叉熵(Binary CrossEntropy); (B)使用時長預測:交叉熵損失(Cross-Entropy);流失預測:均方誤差(MSE); (C)使用時長預測:Hinge 損失(Hinge Loss);流失預測:MAE(平均絕對誤差); (D)兩個任務均使用交叉熵損失,因為兩者的輸出都有不確定性
11. 某工程師在 A100 GPU 叢集上訓練大型語言模型,觀察到以下現象:全批次梯度 下降時 GPU 利用率達 100%,但每次更新耗時 45 秒;隨機梯度下降(SGD)每 次更新僅需 0.01 秒,但梯度極不穩定、訓練曲線震盪劇烈。為兼顧梯度穩定性與 GPU 吞吐量(Throughput),應採用下列哪種策略? (A)全批次梯度下降(Full-batch GD):使用完整資料集計算梯度,更新穩定但每 次更新耗時長; (B)隨機梯度下降(SGD):每次只用一個樣本,速度快但梯度雜訊大,收斂不穩 定; (C)第二階梯度法(Newton's Method):利用 Hessian 矩陣精確估計曲率,大幅減 少更新次數; (D)小批次梯度下降(Mini-batch GD):以適當批次大小(如 256-2048)平衡梯度 估計穩定性與 GPU 平行效率,是深度學習的業界標準
12. 某醫院導入肺癌篩檢模型,資料集中正常病例佔 99%、肺癌陽性僅佔 1%。模型 上線後,系統報告整體準確率(Accuracy)為 99.1%。醫師對此數字感到疑慮, 認為不足以評估臨床價值,在漏診風險上可能存在重大問題。請問在此情境下, 僅以 Accuracy 作為評估指標最嚴重的缺陷為何? (A)Accuracy 對類別不平衡不敏感,可能無法反映模型對肺癌陽性的偵測能力; (B)Accuracy 的計算不包含模型對邊界樣本的分類結果,容易遺漏困難樣本; (C)Accuracy 無法處理多分類問題,在二元分類下需改用 AUC; (D)Accuracy 無法揭示模型的收斂速度,因此不適合用來選擇最終模型
13. 某工程師訓練文本情感分類模型,訓練集 F1=0.96、驗證集 F1=0.71,落差明顯, 115 年第一次 AI 應用規劃師-中級能力鑑定【公告試題】 第三科:機器學習技術與應用 考試日期:115 年 05 月 23 日 第 4 頁,共 18 頁 答案 題目 顯示模型出現過擬合。下列哪一種策略能最直接從降低模型複雜度的角度緩解過 擬合? (A)增加訓練 Epoch 數至 200,讓模型充分學習訓練資料的所有細節; (B)引入更多原始文本特徵(包括原始 URL、HTML 標籤),增加特徵多樣性; (C)對 Embedding 層與全連結層加入 L2 權重衰減(Weight Decay),懲罰參數值; (D)移除驗證集並將其併入訓練集,以增加模型可見的訓練樣本數
14. 某電商平台使用樸素貝氏分類器(Naive Bayes Classifier)建立垃圾郵件過濾模型。 訓練集準確率(Accuracy)達 92%,但上線後發現,包含「限時優惠、立即下單 享折扣」等關鍵字的正常促銷郵件,常被誤判為垃圾信。經分析發現,這些詞彙 在訓練資料中多出現在垃圾郵件中,導致其類別條件機率偏高。請問造成此現象 的最主要原因與較適當的改善方式為何? (A)應禁用 Naive Bayes,改用其他更先進演算法; (B)模型過擬合於訓練資料,應增加 Epoch 數以提升泛化能力; (C)類別條件機率受訓練資料分布影響,導致促銷關鍵字被視為垃圾信特徵,應重 新平衡資料或調整先驗機率; (D)模型未進行特徵標準化(Feature Scaling),導致分類邊界偏移,應先進行正規 化處理
15. 某資料科學家將客戶資料進行分群,使用 K-means(K=5)後發現部分群集呈現 半月形(非凸)結構,且資料中存在少數離群值(Outliers)。他同時觀察到每次 執行結果略有不同。下列敘述何者最完整且準確地反映 K-means 在此情境中的已 知限制? (A)K-means 無法處理維度超過 10 的資料,在高維空間中距離計算失效; (B)K-means 假設群集為高斯分佈,無法處理任何非球形群集; (C)K-means 對 K 值敏感,但初始化不影響最終結果(演算法保證全局最優); (D)K-means 需預先指定 K;以歐氏距離為基礎,難以處理非凸群集;對初始化與 離群值敏感
16. 某資料科學家在信用評分任務中使用 XGBoost 建立模型,發現模型在訓練集表現 良好但驗證集出現過擬合跡象。他檢視其模型設計,發現 XGBoost 在目標函數 (Objective Function)中引入額外的正則化機制以控制模型複雜度。相較於傳統 梯度提升決策樹(GBDT),XGBoost 在其核心目標函數中加入了下列哪一種關鍵 設計,使其具備更強的防過擬合能力? (A)加入樹的複雜度懲罰項(包含深度、葉節點數量與葉節點權重的 L2 正則化); (B)加入動態學習率(Dynamic Learning Rate)的強制衰減機制; (C)加入卷積運算(Convolution)以萃取特徵間的空間關係; 115 年第一次 AI 應用規劃師-中級能力鑑定【公告試題】 第三科:機器學習技術與應用 考試日期:115 年 05 月 23 日 第 5 頁,共 18 頁 答案 題目 (D)強制所有決策樹深度為 1(Decision Stumps)
17. 某醫療新創團隊將原有 3 層 CNN 升級為 16 層架構以提升 CT 影像腫瘤偵測率, 但發現訓練損失反而高於 3 層版本且收斂困難。工程師懷疑是網路深度造成的訓 練問題,下列診斷與對策何者最正確? (A)網路層數增加導致參數量過多,應減少每層卷積濾波器(Filters)數量以降低 模型複雜度; (B)深層網路可能出現梯度消失問題,導致淺層權重難以更新;應採用 ResNet 的 殘差連接(Skip Connection)以改善梯度傳遞; (C)16 層模型對 CT 影像而言仍過淺,應進一步增加網路深度以學習更高階特徵; (D)問題可能來自激活函數(Activation Function),將 ReLU 改為 Sigmoid 可改善 梯度傳遞問題
18. 某工程師設計用於醫療 X 光影像分類的 CNN,發現卷積層後直接接全連結層導 致參數量高達 5,000 萬,訓練速度極慢。為降低模型參數量與計算成本,他在卷 積層後加入池化層(Pooling Layer)。下列何者為池化層在此設計中最主要解決的 問題? (A)降低特徵圖空間維度,減少參數與計算量; (B)提供非線性表達能力,以提升模型學習複雜度; (C)改善梯度消失問題,以強化反向傳播穩定性; (D)提升模型泛化能力而不影響特徵維度
19. 某團隊開發合約文件審查系統,需比對合約首頁的定義條款與第 20 頁的責任條 款是否一致。工程師初版採用雙向長短期記憶(Bidirectional LSTM),但發現長 文件的跨段落語義關聯捕捉效果不佳,且訓練時間隨文件長度明顯增加。改用 Transformer 架構後問題獲得改善,下列何者為最主要的原因? (A)Transformer 參數量比 LSTM 少,因此訓練速度更快、不易過擬合; (B)Transformer 內建位置編碼,使模型天生理解文件的章節結構與段落順序; (C)LSTM 無法處理超過 512 個 token 的輸入,Transformer 無此硬性限制; (D)Transformer 的 Self-Attention 可讓任意 token 直接建立關聯,不受距離限制, 且運算可平行化
20. 工程師在 PyTorch 中建構貓、狗、鳥三分類 CNN,並使用交叉熵損失函數 (CrossEntropyLoss)作為訓練目標。由於此損失函數在內部已包含 Softmax 計 算,輸出層的設計需特別注意。請問輸出層的激活函數(Activation Function)與 輸出維度應如何設定? (A)使用 ReLU 作為激活函數,輸出維度設為 1,直接輸出單一數值作為預測結 果; (B)使用 Sigmoid 作為激活函數,輸出維度設為 3,使每個類別獨立輸出 0 到 1 的 機率; (C)不使用任何激活函數,直接輸出未經正規化的 logits,輸出維度設為 3 對應三 個類別; (D)使用 Softmax 作為激活函數,輸出維度設為 3,輸出為已正規化的機率分布
21. 某工程師將一個大型預訓練模型部署至資源受限的行動裝置,發現模型體積過大 且推論效率不足。為降低模型大小並提升推論速度,他將原本 32-bit 浮點數權重 轉換為 8-bit 整數。在不重新訓練模型的前提下,請問此過程稱為何? (A)知識蒸餾(Knowledge Distillation); (B)權重剪枝(Pruning); (C)張量分解(Tensor Decomposition); (D)模型量化(Quantization)
22. 某工程師建置企業內部知識問答的 RAG 系統,上線後發現部分問題檢索結果與 查詢語意不符。分析後確認問題出在向量搜尋的語意匹配不準確。於檢索階段, 採取下列哪種方法最能直接改善此問題? (A)將切片大小(Chunk Size)由 512tokens 縮小至 128tokens,以提升檢索精細度; (B)調整向量相似度閾值(Similarity Threshold),以過濾低相關檢索結果; (C)採用混合搜尋(Hybrid Search):結合語意向量搜尋與關鍵字搜尋(BM25), 並以 RRF(Reciprocal Rank Fusion)融合排序; (D)將檢索結果隨機洗牌(Shuffle)後回傳給 LLM,避免位置偏誤(Position Bias)
23. 某團隊開發法律文件生成系統,需根據合約前半段內容自動生成後半段條款。工 程師分別使用 BERT 與 GPT-2 進行微調,但發現 BERT 的生成效果明顯較差,且 即使增加訓練資料也無法改善。下列何者為最主要原因? (A)BERT 缺乏法律領域知識,因此生成能力較差; (B)BERT 的分詞方式影響語意理解,導致生成效果不佳; (C)BERT 模型規模較小,因此生成能力不足; (D)BERT 無法根據前文逐步生成後續文字,較不適合此類任務
24. 某推薦系統工程師處理商品類別特徵,該特徵包含約 3,000 個不同商品項目,每 一種商品或其規格皆視為一個獨立類別。請問在高基數(High Cardinality)的情 境下,下列哪一種編碼方式最容易造成維度爆炸問題? (A)目標編碼(Target Encoding); (B)標籤編碼(Label Encoding); (C)Embedding 層(Categorical Embedding); (D)One-Hot 編碼(One-Hot Encoding) 115 年第一次 AI 應用規劃師-中級能力鑑定【公告試題】 第三科:機器學習技術與應用 考試日期:115 年 05 月 23 日 第 7 頁,共 18 頁 答案 題目
25. 某工程師建立房價預測模型,輸入特徵包含屋齡與距捷運站距離(公尺)。他發現 距捷運站距離分布嚴重右偏,經對數(Log)轉換後模型表現明顯改善;但將同樣 轉換套用於屋齡後,模型表現反而下降。下列何者為最可能的原因? (A)屋齡與房價若呈線性關係,Log 轉換反而破壞此結構; (B)Log 轉換會壓縮所有特徵的變異數,導致模型失去鑑別能力; (C)Log 轉換不適用於有單位的連續變數,應改用 Box-Cox; (D)兩特徵須套用相同轉換,否則尺度不一致導致梯度不穩定
26. 在時間序列資料的特徵工程中,工程師常使用滑動窗口(Sliding Window)方法, 將過去多個時間點的觀測值組合為模型輸入。下列何者為此方法的主要目的? (A)資料增強; (B)去除資料雜訊; (C)降低特徵維度; (D)建立滯後特徵
27. 某工程師建立零售商品銷量預測模型,初期以第 1 至 52 週資料作為訓練集、第 53 週作為測試集(固定時間切分)。半年後重新評估,發現模型對最新資料(如 第 80 週)的預測明顯衰退,推測為時間演進導致行為模式改變。若重新設計驗 證策略,應採用下列哪種方法,使每次訓練皆基於最新時間區間資料? (A)K-fold 交叉驗證(K-fold Cross-Validation); (B)分層 K-fold(Stratified K-fold); (C)滾動窗口驗證(Rolling Window Validation / Time Series Split); (D)留一驗證法(Leave-One-Out Cross-Validation)
28. 某房仲平台要預測物件成交價,資料集含 50 個特徵,其中部分特徵與房價呈非 線性關係,且業務單位要求模型須能提供整體特徵重要性以供稽核。下列哪一種 模型選擇策略最符合需求? (A)使用羅吉斯迴歸(Logistic Regression),透過線性係數解釋特徵影響,但無法 有效建模非線性關係; (B)使用隨機森林迴歸(Random Forest Regression),可處理非線性關係,並提供 整體特徵重要性(Feature Importance)作為解釋依據; (C)用 K-means 分群(K-means Clustering)後分別建立迴歸模型,以提升預測準確 度並間接提升可解釋性; (D)使用支持向量迴歸(Support Vector Regression, SVR),透過核函數(Kernel Function)捕捉非線性關係,並以支持向量解釋模型決策
29. 某工廠設備監測系統需偵測馬達軸承的異常振動,但過去僅記錄了大量正常運作 的振動時序資料,缺乏任何已確認故障的標註樣本。請問下列何種任務範疇最符 115 年第一次 AI 應用規劃師-中級能力鑑定【公告試題】 第三科:機器學習技術與應用 考試日期:115 年 05 月 23 日 第 8 頁,共 18 頁 答案 題目 合此情境下的異常偵測需求? (A)監督式二元分類(Supervised Binary Classification); (B)非監督或半監督異常偵測(Unsupervised / Semi-supervised Anomaly Detection); (C)強化學習(Reinforcement Learning); (D)自監督學習(Self-supervised Learning)
30. 某信用風險模型:訓練 AUC=0.97、驗證 AUC=0.72、少數違約樣本預測波動極大 及不同 K-fold 切分結果差異明顯。下列何者為最可能的問題? (A)高偏差; (B)高變異; (C)過擬合; (D)資料漂移
31. 某倉儲自動化公司以強化學習(Reinforcement Learning, RL)訓練機器手臂進行 揀貨,獎勵函數設計為「每成功抓取一個貨品得+1 分」。部署後發現機器手臂學 會反覆放開再抓取同一物品,以累積分數,但實際完成任務的效率極低。請問此 現象的核心問題為何?應如何修正獎勵設計? (A)獎勵塑形(Reward Shaping):將獎勵改為「成功完成一次揀貨任務」而非單次 抓取行為; (B)策略退化(Policy Degradation):降低學習率以穩定訓練; (C)信用分配問題(Credit Assignment Problem):引入優勢函數(Advantage Function); (D)災難性遺忘(Catastrophic Forgetting):加入經驗回放(Replay Buffer)
32. 某詐欺偵測模型需同時具備高精確率(Precision),以避免誤凍結正常帳號,並維 持高召回率(Recall)表現,以確保不放過任何詐欺行為。然而工程師發現兩者之 間存在取捨關係(Precision-Recall Tradeoff)。在此情境下,F1-score 最能反映何種 特性? (A)F1-score = (Precision + Recall) / 2,為算術平均; (B)F1-score 為 Precision 的加權平均; (C)F1-score 僅適用於類別平衡資料; (D)F1-score = 2 × (Precision×Recall)/(Precision+Recall),為調和平均,對較小值敏 感
33. 某工程師的多元線性迴歸模型包含 150 個特徵,其中許多特徵高度相關(如「建 坪」與「總面積」)。他同時希望控制過擬合且保留所有特徵的解釋能力,不讓任 何特徵係數歸零,下列哪一項正則化方案最適當? (A)Lasso 迴歸(L1 正則化):透過絕對值懲罰使部分係數歸零,具有特徵選擇效 115 年第一次 AI 應用規劃師-中級能力鑑定【公告試題】 第三科:機器學習技術與應用 考試日期:115 年 05 月 23 日 第 9 頁,共 18 頁 答案 題目 果; (B)Ridge 迴歸(L2 正則化):透過平方懲罰縮小所有係數,在共線性下穩定估計 且不歸零; (C)Elastic Net(L1+L2):結合稀疏性與穩定性,但部分係數仍可能被壓為 0; (D)無正則化的 OLS 迴歸:不控制過擬合,在共線性下係數估計不穩定
34. 某工程師使用 XGBoost 模型進行調參,需對以下超參數進行網格搜尋(Grid Search):learning_rate(3 個候選值)、max_depth(4 個)、n_estimators(5 個)、 subsample(3 個)、colsample_bytree(3 個)。每組參數組合皆需完整進行 5-Fold 交叉驗證。請問總共需要訓練幾個模型? (A)3 + 4 + 5 + 3 + 3 = 18 個; (B)5 × 5 = 25 個; (C)max(3,4,5,3,3) × 5 = 25 個; (D)3 × 4 × 5 × 3 × 3 × 5 = 2,700 個
35. 某團隊使用 LoRA 微調大型語言模型進行法律摘要任務,發現模型在複雜條款的 摘要上常出現內容遺漏,但 GPU 顯存已接近上限。下列哪種調整方式最能在不 明顯增加記憶體使用的前提下改善模型表現? (A)提高 LoRA rank 以增強模型表達能力; (B)改用完整微調(Full Fine-tuning)以學習更多細節; (C)降低 LoRA rank 以釋放記憶體並增加 Batch Size; (D)降低 LoRA rank 但套用到更多層,保持 trainable 總參數不變
36. 某金融機構的 AI 信用評分模型需上傳至第三方雲端服務商進行推論。法務部門 要求:在不解密資料的前提下,由單一雲端服務商直接對加密資料進行模型運算。 下列哪種隱私保護技術最符合此需求? (A)聯邦學習(Federated Learning); (B)同態加密(Homomorphic Encryption); (C)差分隱私(Differential Privacy); (D)安全多方計算(Secure Multi-Party Computation, MPC)
37. 某銀行導入 AI 貸款審核系統,監管要求每筆被拒絕的申請須提供可理解的拒絕 原因。技術主管評估以下方案,哪一種最能實現個別預測的局部可解釋性(Local Explainability)? (A)SHAP(SHapley Additive exPlanations)值:計算每個特徵對單筆預測的貢獻; (B)全域特徵重要性(Global Feature Importance):說明整體特徵影響,無法解釋 單一個案; (C)Grad-CAM(Gradient-weighted Class Activation Mapping):以熱力圖解釋影像 模型; (D)混淆矩陣(Confusion Matrix):呈現整體分類表現
38. 某公司導入 AI 履歷篩選系統,用於自動決定是否進入面試。模型對男性應徵者 的面試通過率為 55%,對女性應徵者為 30%。在其他條件不變的情況下,工程師 需評估模型是否符合統計均等(Statistical Parity)的公平性定義。下列何者最正 確? (A)符合統計均等,因為模型未使用性別作為輸入特徵; (B)符合統計均等,因為兩個族群皆有部分應徵者被錄取; (C)不符合統計均等,因為不同群體的正向決策比例(通過率)存在明顯差異; (D)不符合統計均等,因為女性族群的預測準確率較低
39. 某銀行信貸模型上線後稽核發現,女性申請者中「實際具有還款能力卻被模型拒 絕」的比例顯著高於男性,但法務限制不允許在推論階段使用性別欄位調整輸出。 下列去偏策略何者在此限制下仍可執行? (A)訓練中(In-processing):在損失函數加入公平性懲罰項,降低不同群體的錯誤 拒絕比例差異; (B)前處理(Pre-processing):僅於訓練資料進行重新採樣,無法直接修正既有模 型在推論階段的偏誤; (C)後處理(Post-processing):依性別分組調整決策門檻,使不同群體的錯誤拒絕 比例一致; (D)改用人口統計均等指標(Demographic Parity),錯誤拒絕比例差異將自動消失
40. 分析師準備建立一個能將手寫數字圖片(28x28 像素展平為 784 維度)分為 0~9 共 10 個類別的多層感知機(MLP),且標籤已轉為 One-Hot 編碼(One-Hot Encoding)。 為符合 10 個類別的單標籤分類需求,下圖中的程式碼中( A )與( B )的函數應填入何者? (A) sigmoid,mean_squared_error; (B) softmax,categorical_crossentropy; (C) relu,binary_crossentropy; (D) tanh,sparse_categorical_crossentropy
41. 工程師使用 PyTorch 建立 OCR 訓練 pipeline,並對手寫字母資料集套用下圖程式進行資料增強(Transform)。模型在訓練過程中顯示驗證損失(Validation Loss)持續 下降,但實際部署後,系統在辨識「b/d/p/q」類字母錯誤率異常偏高。下列何者為 最可能的根本原因? (A) RandomRotation(15)角度過大導致特徵變形,應降至 5 度以內; (B) RandomHorizontalFlip 破壞字母方向語義,使模型以 50%機率學到鏡像錯誤標 籤; (C) ColorJitter 改變筆畫灰階,導致邊緣偵測特徵失真; (D) ToTensor( )應放在所有幾何變換之前才能保持座標對應正確
42. 觀察程式中行( A )將所有既有權重的梯度計算關閉,這在遷移學習中屬於哪一種標 準策略? (A)全面微調(Full Fine-Tuning); (B)零樣本學習(Zero-shot Learning); (C)特徵萃取(Feature Extraction); (D)知識蒸餾(Knowledge Distillation)
43. 在進行遷移學習微調(Fine-Tuning)時,通常會將優化器的學習率(Learning Rate) 設得非常小(如 1e-4),下列何者為主要的原因? (A)為了避免記憶體耗盡(OOM); (B)為了加速模型整體的收斂時間; (C)為了讓損失函數強制歸零; (D)為了避免更新步伐過大,破壞預訓練模型原本已學好的良好特徵表示
44. 研究人員撰寫的程式中(下圖),先用整體資料進行 LDA(Linear Discriminant Analysis)降維,接著再用 KNN(K-Nearest Neighbors)進行分類,並用交叉驗證來評估準確率。請問下列敘述何者正確? (A)此寫法完全正確,因為先以整體資料進行 LDA 降維,再以交叉驗證測試 KNN, 是標準流程; (B)此寫法存在資料洩漏(Data Leakage)問題,應將 LDA 納入交叉驗證流程中一 併進行; (C)雖然流程不夠嚴謹,但結果仍然能夠代表模型真實的泛化能力; (D)如果只想驗證 KNN 的分類效果,可以直接跳過 LDA 步驟,以簡化流程
45. 研究人員在程式(下圖)中使用 cross_val_score 進行交叉驗證,但目前尚未設定 cv 參數。 他們希望確保在每次資料分割時,訓練集與測試集的類別比例與原始資料一致,以 免影響模型的準確率估計。目前有以下幾段候選程式碼可供選擇。請問為了確保在 交叉驗證時每個分割中的類別比例與原始資料一致,上面哪幾段程式碼插入在原 始程式中[#填入程式碼]的部分比較合適? (A)程式碼 B、程式碼 C、程式碼 D; (B)程式碼 A、程式碼 C; (C)程式碼 A、程式碼 B、程式碼 D; (D)程式碼 C、程式碼 D
46. 參考下圖資料處理,下列哪一項描述組合正確?(A)描述 A、描述 C、描述 F; (B)描述 B、描述 D、描述 E、描述 F; (C)描述 B、描述 C、描述 E、描述 F; (D)描述 A、描述 B、描述 D、描述 E、描述 F
47. 參考下圖建立模型結果,下列哪一項描述組合正確? (A)描述 A、描述 C; (B)描述 C、描述 E、描述 F; (C)描述 A、描述 D、描述 E; (D)描述 D、描述 E、描述 F
48. 參考下圖繪圖結果,當 Epochs=6 時,訓練曲線值(0.81)明顯大於驗證曲線值(0.72), 下列何者為最可能的原因?(A)學習率(Learning Rate)太低; (B)批次大小(Batch Size)設定太大; (C)模型低度擬合(Underfitting); (D)模型過擬合(Overfitting)
49. 若團隊需要建立一個超過 50 層的深層神經網路,以捕捉晶圓表面細微的劃傷特徵, 但又擔心傳統深層網路常見的梯度消失(Vanishing Gradient)問題,則下列哪一種 經典架構最適合優先考慮? (A)VGG(Visual Geometry Group):透過重複堆疊 3×3 卷積層與池化層來維持梯度 穩定; (B)GoogLeNet:透過 Inception 模塊並行使用不同大小的卷積核,以避免深層網路 的梯度問題; (C)ResNet ( Residual Network ): 透 過 殘 差 連 接 ( Residual Connection / Skip Connection),使梯度能跨層傳遞並降低深層訓練困難; (D)Vision Transformer(ViT):完全捨棄卷積,因此不會出現任何深層模型的訓練 問題
50. 為了修復訓練過程中 Loss 突然變成 NaN 的問題,工程師考慮在 PyTorch 訓練迴圈 中加入梯度裁剪(Gradient Clipping)機制,例如 torch.nn.utils.clip_grad_norm_。若要正確加入梯度裁剪,最適合插入於哪個位置?其主要作用為何? (A)插入於位置 3 與位置 4 之間;用以限制 Loss 數值大小,避免梯度消失; (B) 插入於位置 4 與位置 5 之間;用以限制梯度範數過大,避免更新步幅失控導致 數值不穩; (C) 插入於位置 5 之後;用以將更新後的權重強制壓縮回正常範圍; (D)插入於位置 1 與位置 2 之間;用以對輸入影像進行批次標準化
 阿摩線上測驗
登入
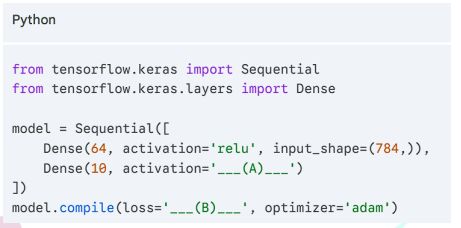 (A) sigmoid,mean_squared_error; (B) softmax,categorical_crossentropy; (C) relu,binary_crossentropy; (D) tanh,sparse_categorical_crossentropy
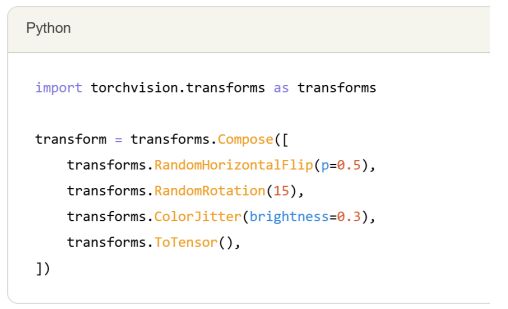 (A) RandomRotation(15)角度過大導致特徵變形,應降至 5 度以內; (B) RandomHorizontalFlip 破壞字母方向語義,使模型以 50%機率學到鏡像錯誤標 籤; (C) ColorJitter 改變筆畫灰階,導致邊緣偵測特徵失真; (D) ToTensor( )應放在所有幾何變換之前才能保持座標對應正確
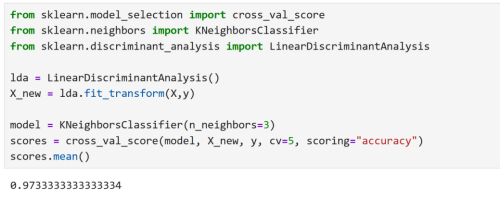 (A)此寫法完全正確,因為先以整體資料進行 LDA 降維,再以交叉驗證測試 KNN, 是標準流程; (B)此寫法存在資料洩漏(Data Leakage)問題,應將 LDA 納入交叉驗證流程中一 併進行; (C)雖然流程不夠嚴謹,但結果仍然能夠代表模型真實的泛化能力; (D)如果只想驗證 KNN 的分類效果,可以直接跳過 LDA 步驟,以簡化流程
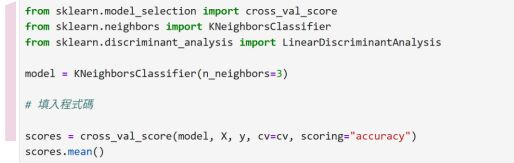
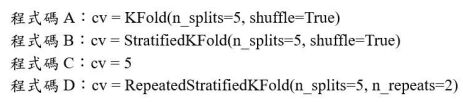 (A)程式碼 B、程式碼 C、程式碼 D; (B)程式碼 A、程式碼 C; (C)程式碼 A、程式碼 B、程式碼 D; (D)程式碼 C、程式碼 D
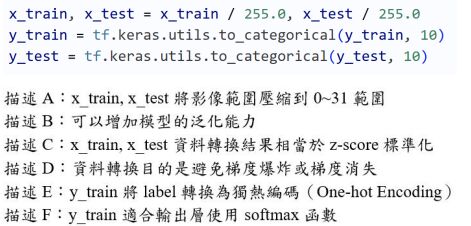 (A)描述 A、描述 C、描述 F; (B)描述 B、描述 D、描述 E、描述 F; (C)描述 B、描述 C、描述 E、描述 F; (D)描述 A、描述 B、描述 D、描述 E、描述 F
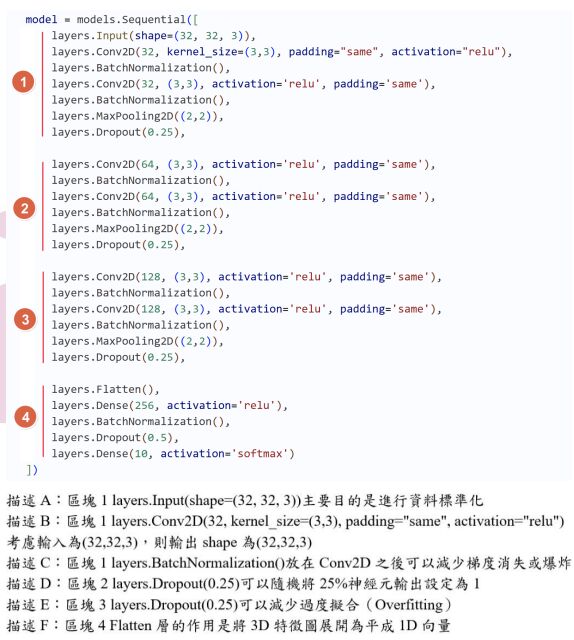 (A)描述 A、描述 C; (B)描述 C、描述 E、描述 F; (C)描述 A、描述 D、描述 E; (D)描述 D、描述 E、描述 F
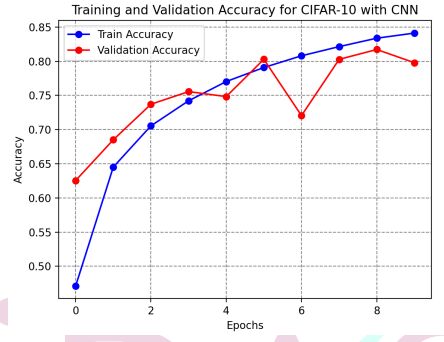 (A)學習率(Learning Rate)太低; (B)批次大小(Batch Size)設定太大; (C)模型低度擬合(Underfitting); (D)模型過擬合(Overfitting)
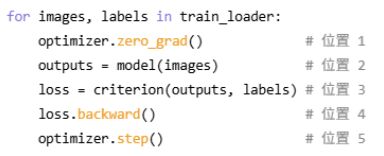 (A)插入於位置 3 與位置 4 之間;用以限制 Loss 數值大小,避免梯度消失; (B) 插入於位置 4 與位置 5 之間;用以限制梯度範數過大,避免更新步幅失控導致 數值不穩; (C) 插入於位置 5 之後;用以將更新後的權重強制壓縮回正常範圍; (D)插入於位置 1 與位置 2 之間;用以對輸入影像進行批次標準化