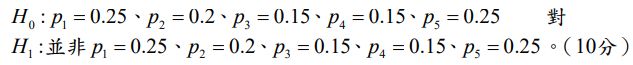所屬科目:統計學
⑴考慮下列隨機變數X其機率密度函數(probability density function): 其中 f1(x)為一平均值為1及標準差為σ 的常態機率密度函數(normal probability density function),而 f2(x)為一平均值亦為1及標準差為2σ 的常態機率密度函數。 下列為一組服從上述機率分配所得的隨機樣本: 請算出 σ2 之最大概似估計量的值。
⑵若某一次國家考試其某考試科目共有25題單選題,隨機變數X代表考生答對題數,且X之分配是每題答對機率為 p 的二項式分配(binomial distribution),下列是隨機取得6個考生答對題數資料: 根據上述資料,請算出X的標準差之最大概似估計量的值及 p的最小變異不偏估計量的值。
⑵在顯著水準α= 0.05,利用F檢定法檢定 H0 :β1=0對H1 :β1≠ 0 。
⑶在顯著水準α= 0.05,利用t檢定法檢定H0 :β1≥ 1 對H1 : β1 <1 。
⑴假定某地區的每日最高溫服從一平均值為μ 及標準差為4的常態分配。 針對下列假設, H0 :μ= 28 對 H1 :μ =30,隨機取得16筆此地區當日 最高溫資料。估計量為樣本平均值。給定下列3種檢定法:
檢定法A: 若> c 則拒絕H0,反之則不拒絕H0;
檢定法B:若 > 30.17則拒絕H0,反之則不拒絕H0;
檢定法C:若 <30.5則拒絕H0,反之則不拒絕H0。
已知檢定法A之檢定力(power)為0.1587,且設定顯著水準為α= 0.015,請計算的值並決定上述3個檢定法那一個或那一些符合設定並有最大檢定力。
⑵一軟體公司欲比較一新版軟體是否較舊版軟體更能有效率執行程式;假定μ1為舊版軟體執行測試程式的平均執行時間,而μ2為新版軟體執行測試程式的平均執行時間,且x1,…,x6為舊版軟體執行測試程式之執行時間的隨機資料,而y1,…,y6為新版軟體執行測試程式之執行時間的隨機資料。給定下列資訊:x1,…,x6之平均值為7且變異數為5.6,而y1,…,y6之平均值為6且變異數為2.4,x1,…,x6與y1,…, y6之相關係數為0。請分別用獨立樣本(independent samples)t檢定法,即將x1,…,x6與y1,…,y6視為獨立樣本,及成對樣本(paired samples or matched samples)t檢定法,即將(x1,y1),…,(x6,y6)視為成對樣本,在顯著水準α= 0.01,檢定H0 : μ1≤μ2–2.5 對 H1 :μ1>μ2–2.5 。
⑶某民調機構欲比較候選人A的支持率p1 與候選人B的支持率p2 的差異。下列是此民調機構關於兩候選人支持度的兩份問卷: 已知根據上述問卷所得 p1– p2 之95%信賴區間其長度為0.0392,以及候選人A的支持人數大於候選人B的支持人數,即n < 2450。請算出n的值,並利用上述問卷得到 p2 的95%信賴區間。
六. 欲比較3種品牌汽車其耗油程度,給定A品牌汽車其每公升行駛平均里程數為μ1,B品牌汽車其每公升行駛平均里程數為μ2,而C品牌汽車其每公升行駛平均里程數為μ3。每種品牌各隨機抽測8台汽車並得到其每公升行駛里程數。下列是關於此3組樣本其相關資訊以及利用這3組樣本所做的統計分析: 此3組樣本其平均值為A品牌之平均里程數最大,而B品牌之平均里程數最小,此3組樣本其標準差皆相同,檢定 H0:μ1= μ2 對 H1 : μ1≠ μ2 的獨立樣本t檢定其t統計量絕對值為2,檢定 H0 : μ2= μ3 對 H1 : μ2≠ μ3 的獨立樣本t檢定其t統計量絕對值為1。在顯著水準α= 0.05,請利用單因子變異數分析法(one-way ANOVA)來檢定此3種品牌汽車其耗油程度 是否一致,即檢定 H0 : μ1= μ2=μ3 對 H1 : μ1 、μ2以及μ3並不完全相等。
七. 根據一份國人讀報偏好之報告指出,最常看A報的比率為 p1 = 0.25,B報的比率為 p2 = 0.2,C報的比率為 p3= 0.15,D報的比率為 p4 = 0.15,而其他報的比率為 p5= 0.25。下列是一份關於民眾看報的問卷資料: 在顯著水準α= 0.1,利用上述問卷資料以及卡方檢定(chi-squared test) 來驗證上述報告是否可靠,即檢定:
 阿摩線上測驗
登入
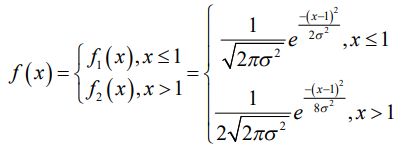 其中 f1(x)為一平均值為1及標準差為σ 的常態機率密度函數(normal probability density function),而 f2(x)為一平均值亦為1及標準差為2σ 的常態機率密度函數。 下列為一組服從上述機率分配所得的隨機樣本:
 請算出 σ2 之最大概似估計量的值。
 根據上述資料,請算出X的標準差之最大概似估計量的值及 p的最小變異不偏估計量的值。
 為樣本平均值。給定下列3種檢定法:
 > c 則拒絕H0,反之則不拒絕H0;
 > 30.17則拒絕H0,反之則不拒絕H0;
 <30.5則拒絕H0,反之則不拒絕H0。
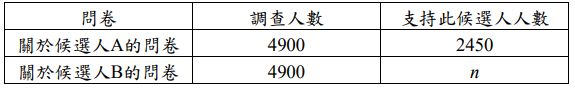 已知根據上述問卷所得 p1– p2 之95%信賴區間其長度為0.0392,以及候選人A的支持人數大於候選人B的支持人數,即n < 2450。請算出n的值,並利用上述問卷得到 p2 的95%信賴區間。
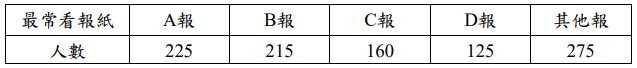 在顯著水準α= 0.1,利用上述問卷資料以及卡方檢定(chi-squared test) 來驗證上述報告是否可靠,即檢定: